session-reader
Verified@1agents/session-reader · v0.8.4 · MIT · Web UI
Read Plane: cross-agent session discovery, turn inspection, workspace aggregation and distillation from raw local session files.
Install
dsh plugin add @1agents/session-reader Confirm the layer applied with dsh --profile default --dump-config — see the install guide.
Source
Tags
Creators
Readme
@1agents/session-reader
在 DSH Web 中查看跨智能体历史,也可作为独立 1session CLI 与 TypeScript 库使用。
支持 Claude Code、Codex、Antigravity、Grok 和 DeepSeek Harness:发现会话、搜索原文、逐轮查看,并按工作目录聚合。Read Plane(读平面)以本地原始会话文件为唯一准绳,不修改原始会话;本地 SQLite 索引用于加速检索,可从源文件重建。只读浏览不依赖 ACP 服务或常驻守护进程。
DSH Web 快速安装
要求 Node.js >= 22.15,并已安装 DeepSeek Harness。在终端运行:
dsh plugin --profile web add @1agents/session-reader
dsh web
包内的 dsh.bundle.patch 会在安装时启用插件。已经运行 DSH Web 时,安装或升级后重启服务,再打开侧栏「历史会话」。从 DSH 源码仓库运行时,在以上命令前加 pnpm;使用其他 profile 时将 web 替换为对应名称。
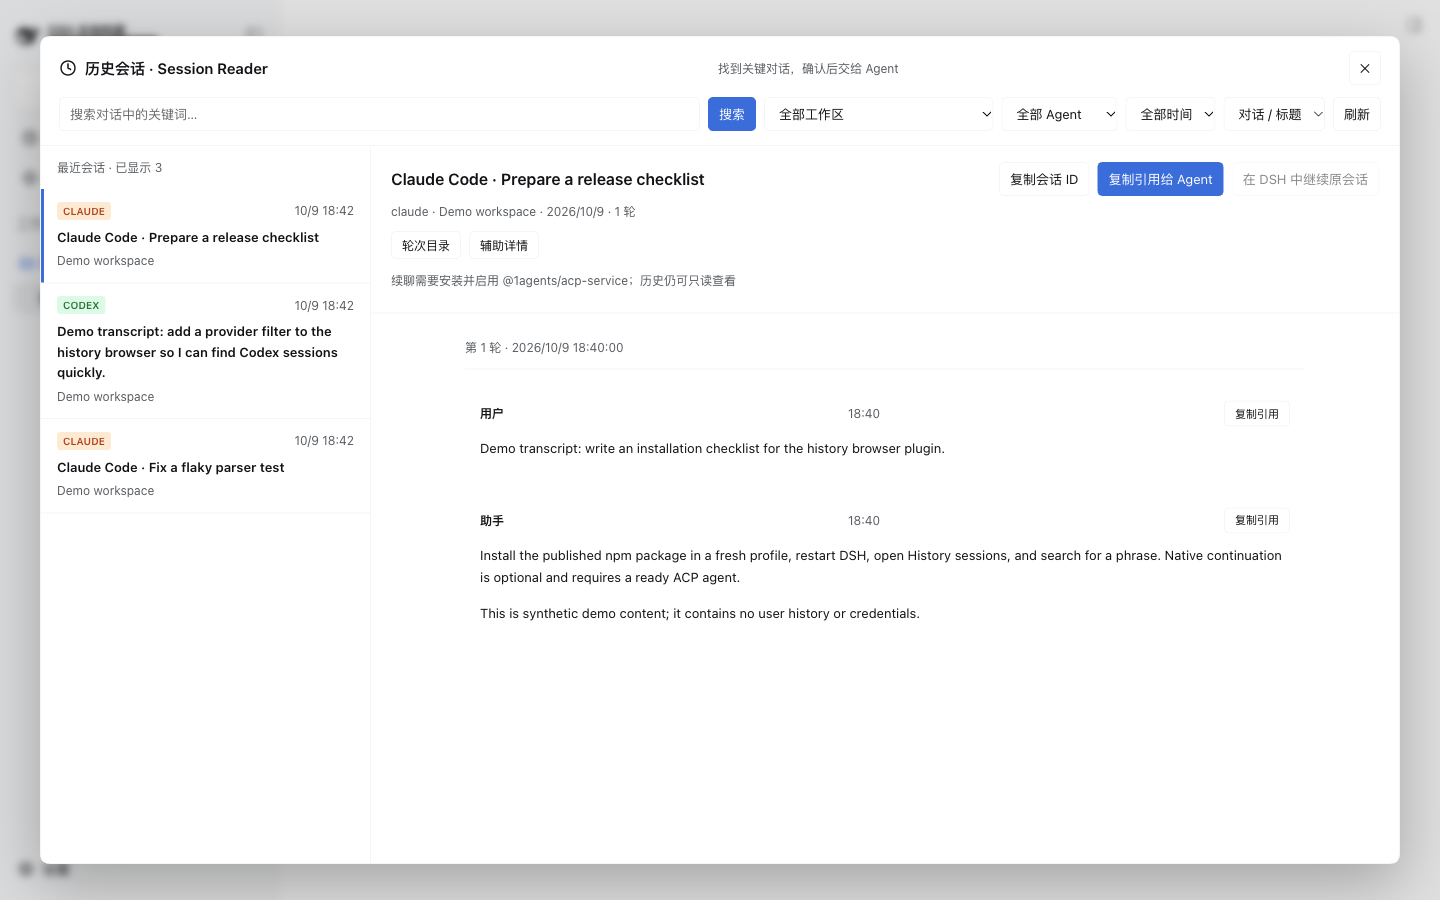
截图使用独立测试 profile 中的合成示例会话。拍摄环境与验证范围。
五种来源均可只读浏览。要在 DSH 中继续 Claude、Codex、Grok 的原生会话,还需安装可选的 @1agents/acp-service,配置对应 Agent 的 CLI 与登录状态,并保留原工作目录;DSH 来源打开原 DSH 会话,Antigravity 目前仅供浏览。详细条件见在 DSH 中继续原会话。
覆盖的智能体
| Provider | 落盘位置 | 工作区来源 |
|---|---|---|
antigravity |
~/.gemini/antigravity/brain/<uuid>/.system_generated/logs/transcript.jsonl(+ 同级 implementation_plan.md / walkthrough.md 等产出物) |
run_command 的 Cwd;缺失时由所操作文件向上找 .git |
claude |
~/.claude/projects/<slug>/<session-id>.jsonl |
条目自带的 cwd 字段(目录 slug 只用作快速预筛) |
codex |
~/.codex/sessions/<YYYY>/<MM>/<DD>/rollout-*.jsonl |
session_meta / turn_context 的 cwd |
dsh(DeepSeek Harness) |
~/.dsh/sessions/<slug>/session-<uuid>/session.v{2,4}.jsonl[.zstd](支持 zstd 分帧压缩) |
开篇 session 记录的 cwd |
grok |
~/.grok/sessions/<percent-encoded cwd>/<uuid>/chat_history.jsonl(+ 同目录 events.jsonl / rewind_points.jsonl / updates.jsonl / summary.json / goal/*.md) |
summary.json 的 info.cwd;目录名本身就是 cwd 的百分号编码,可反解 |
所有会话被归一为同一组 TurnEvent:user / assistant / thinking / tool_call / tool_result。
两家新来的各自带一个别人没有的麻烦,都在解析层吃掉了:
- dsh 的 zstd 是「一次 flush 一帧」追加出来的,整个文件是若干完整帧首尾相接。Node 的
zstdDecompressSync和createZstdDecompress都只解第一帧就停——不报错,只是安静地 少给你 99% 的会话。src/util/zstd.ts按 RFC 8878 的帧头逐帧走位(不解压就能算出每帧 边界),整文件读全;正在写入的半截尾帧丢掉而不是毒化整个会话。 - grok 的
chat_history.jsonl里一个时间戳都没有。时间、工具成败、后台回执分散在同目录 的侧文件里:events.jsonl的tool_started/tool_completed(按tool_call_id对上,给 出耗时与outcome)、rewind_points.jsonl的prompt_index → created_at(用户消息的 确切时刻)、updates.jsonl的 ACP 流(助理消息与思考的时刻,按文本本身对上而不是按 位置猜;对不上就宁可不给时间戳)。token 记账也只有updates.jsonl有,没有这个文件的 会话就如实不报 token。
安装
npm install @1agents/session-reader   # 作为库
npm install -g @1agents/session-reader  # 作为 1session 命令
npx @1agents/session-reader list      # 不安装直接用
要求 Node.js >= 22.15(node:sqlite 建索引,node:zlib 的 zstd 读 dsh 的压缩会话;zstd 是 22.15 才进 node:zlib 的)。
运行时依赖为 @1agents/chat-ui、@1agents/dreammate-network、@1agents/dreammate-node 和 preact,由包管理器自动安装。解析与索引使用 Node.js 文件、压缩及 SQLite API;不需要另装数据库服务。
内置 skill:一条命令装到五家智能体
1session 自带一个 skill(skills/1session/),装进各家智能体自己的 skills 目录后,
它们在用户问起"上次/之前/那个报错"时会自己想起来调这个 CLI,而不需要你每次手动贴命令。
1session skill install        # 链接到五家(未安装的智能体会跳过)
1session skill status         # 看五家各自是什么状态
1session skill uninstall      # 撤掉
| 智能体 | 落位 |
|---|---|
| claude | ~/.claude/skills/1session |
| codex | ~/.codex/skills/1session |
| antigravity | ~/.gemini/antigravity/skills/1session(不是 ~/.gemini/skills,那是 gemini-cli 的位) |
| grok | ~/.grok/skills/1session |
| dsh | ~/.dsh/skills/1session |
五家的格式完全一致(<dir>/<name>/SKILL.md + YAML frontmatter),所以装的是同一份文件。
默认建符号链接而不是拷贝:下次 npm i -g @1agents/session-reader@latest 升级后,
各家看到的 skill 自动就是新的,不用记着重装。Claude Code 实测会跟随符号链接并热加载。
如果某家的加载器不认符号链接(表现是 status 显示已链接、但智能体里看不到这个 skill),
用 1session skill install --copy 换成拷贝——代价是升级后要重跑一次安装,status
会把"拷贝与当前包不一致"显式标出来。
其他开关:--agent claude,codex(只装指定的几家,即使该智能体尚未安装也会建目录,
方便先装 skill 后装智能体)、--dry-run(只说会做什么)、--force(覆盖同名条目)。
别用 npx 跑 skill install。 默认的链接模式会指回包所在目录,而 npx 装的那份在
~/.npm/_npx/<hash>/ 的缓存里,npm 自己会清。清掉那天五家的 skill 一起静悄悄消失。
先 npm i -g 再 skill install;实在要从 npx 引导就加 --copy,把字节交给各家自己拿着。
传播给别人时,两行就够——第二行是大家会忘的那行:只装 CLI 的人得自己记着它存在, 两行都跑了的人是智能体替他记着。
npm i -g @1agents/session-reader
1session skill install
skill 自己也带着这套安装说明(skills/1session/references/install.md):即便对方只拿到
一份 SKILL.md、机器上没有 CLI,它也会先用 npx 把问题回答掉,再回头提一次永久安装。
CLI
# 开发态(无需构建)
npx tsx bin/1session.ts <command>

# 构建后
npm run build && node dist/bin/1session.js <command>
| 命令 | 说明 |
|---|---|
1session list [--limit n] [--scope <path>|cwd|global] [--provider name] [--since 24h] [--json] |
按最近更新列出各智能体的会话(默认当前 pwd 子树,见 --scope) |
1session overview <session-id> [--json] |
第 1 层:统计卡片(轮次/文件/命令/提交/产物/上传/后台任务/token)+ 目标、口径修正、状态锚点、全量落盘 |
1session turns <session-id> [--json] |
第 2 层:逐轮概要——时间、耗时、事件区间、文件/命令/失败数、用户说了什么、agent 回了什么 |
1session turn <session-id> <n> [--event k|a-b|a,b,c] [--json] |
第 3 层:默认读取用户与助手的可见正文、附工具目录;支持批量轮次、--locator、--call、--artifact、--raw 和游标分页 |
1session digest <session-id> [--focus marketing|review|full] [--json] |
单会话蒸馏:目标、改动文件、命令、关键节点 |
1session workspace [path] [--since 24h] [--limit n] [--digest] [--focus f] [--json] |
按 pwd 跨智能体聚合(默认 .);带 --digest 输出统一故事线 |
1session jobs <id> [--json] |
异步作业账本:状态 + 证据 + pid / host / log |
1session commands <id> [--failed] [--host h] [--turn n] [--json] |
命令账本:exit_code / 耗时 / cwd |
1session files <id> [--group project|runtime|log|all] [--json] |
文件账本,按项目 / 运行态 / 日志分组 |
1session errors <id> [--json] |
失败命令,带 stderr 与"同前缀命令后续是否成功" |
1session search <query> [--scope <path>|cwd|global] [--since 24h] [--limit n] [--kind k1,k2] [--regex] [--case] [--context n] [--max-hits n] [--include-self] [--json] |
关键词检索:默认搜对话与已落盘标题 / 摘要;--area 选择工具或产物,--session 限定会话,支持排序、分组与游标 |
1session index [<id>] [--all] [--scope <path>|cwd|global] [--force] [--since 30d] |
建立 / 刷新索引;--all 全库回填 |
1session graph <id> [--json](别名 related) |
会话之间的引用关系 + 每条边的证据 |
1session skill install|status|uninstall [--agent a,b] [--copy] [--force] [--dry-run] |
把内置 skill 装进五家智能体的 skills 目录(见上) |
全局开关 --no-index 绕过索引直读源文件。
关键词、ID 与原文读取
检索只使用已落盘内容与确定性规则,不生成 AI 概要,不引入向量检索。
--area |
可搜索字段 |
|---|---|
dialogue(默认) |
用户 / 助手可见正文、当前标题、已保存的 AI / 自定义标题、provider 已保存的会话摘要 |
tools |
工具名、参数、结果;Antigravity 可恢复的完整输出也参与检索 |
artifacts |
已识别产物的名称、路径、摘要与文本正文 |
all |
上述三类合并;仍不包含 thinking |
--kind 显式限定事件类型时,只搜索指定事件。默认轮次阅读保留所有可见消息的顺序、换行与代码块,
工具参数 / 结果按需读取;thinking 和指令封套不进入默认预览。系统提示词没有统一字段:--raw 可核对所选事件记录中保存的指令封套;
未对应归一化事件的独立系统记录,仍需打开源文件查看。不补造缺失内容。
1session search 'src/ledger.ts' --global --area tools
1session search '发布 npm' --global --sort time
1session search ignored --global --terms '["发布","完成"]' --operator and
1session search '超时' --global --session 'claude:<完整原生ID>' --max-hits 10 --json
1session turn 'claude:<完整原生ID>' 2-4 --json
1session turn 'claude:<完整原生ID>' --locator '<命中的event:引用>' --json
1session turn 'claude:<完整原生ID>' --call '<原生调用ID>' --json
1session turn 'claude:<完整原生ID>' --artifact '<命中的产物路径>' --json
1session turn 'claude:<完整原生ID>' --locator '<event:引用>' --raw --json
普通 query 是一个字面字符串,空格不会自动分词。--terms 提供明确的 AND / OR 条件;
AND 在同一消息的字段内匹配,也可跨同一原生工具调用的参数与结果匹配,不拼接无关轮次。
默认按字段优先级(标题、对话 / 工具名 / 参数、结果等)、时间倒序与稳定 ID 排序;
--sort time 优先时间。事件缺少时间时使用会话更新时间,并标记 timeSource: session。
JSON 返回命中字段、字符区间、片段、轮次 / 调用分组,以及未展示数量和 nextCursor。
每个字段最多展示 20 个字符区间,更多区间用 hasMoreRanges 标明;原文不受该展示上限影响。
推荐保存 provider:完整原生ID 与事件 locator。短 ID 仅允许唯一匹配;重名直接报错并列候选,
即使索引只收录了部分会话也会核对源目录。Tn / En 是当前解析下的便捷序号,不作为持久 ID。
有原生记录 ID 时 locator 随追加保持稳定;缺少原生 ID 时使用记录序号与校验和,源记录改写后拒绝旧引用。
工具结果只按原生调用 ID 关联;没有 ID 的调用标为 unconfirmed,不猜测相邻结果。
turn 默认每页最多 32,000 个字符,可用 --max-chars 调整,接着用相同选择器和 --cursor 继续。
正文保持原始换行与代码块;JSON 的 offset / totalChars 表明读取进度。--raw 要求 --event 或
--locator,读取对应的原始 JSONL 记录(含默认视图隐藏字段)。来源发生相关变化时游标报错,要求重新读取。
provider 已截断且没有旁路原文时会明确提示;索引和分页不会再次丢弃尾部。
共享 TypeScript API 为 readTurnDirectory、readTurns、readEvents、readOriginalRecords、readCall、
readArtifact。HTTP 使用 /v1/sessions/<id>/content?turns=2-4,或 event=<locator>、call=<id>、
artifact=<path>;附 raw=true 可读原始事件记录。面向 agent 的 CLI / DSH 工具使用相同检索核心与游标协议。
索引新增轮次区间与事件 / 调用索引,局部读取只加载所选范围;首次升级按现有缓存策略重建一次。
--scope:会话按路径子树取
list / search / index --all 默认只看当前 pwd 这棵子树下的会话;跨项目要显式说出来。--scope 取三种值:
| 值 | 含义 |
|---|---|
省略 / cwd |
当前 pwd 及其所有子目录下的会话 |
相对路径(..、../web、~/proj)或绝对路径(/Users/me/proj) |
该目录及其所有子目录下的会话 |
global(或 --global,或 --scope /) |
全部会话 |
按子树取而不是按目录相等取:--scope ~/Documents 会列出 ~/Documents 下每一个项目的会话,而不只是恰好在 ~/Documents 里启动的那几个。目录写错会直接报错,不会静悄悄地返回"0 个会话"。
1session list                        # 当前项目(含子模块)
1session list --scope ..             # 连同同级的兄弟项目
1session list --scope ~/Documents    # 这棵树下的全部项目
1session list --global               # 全部
1session search "超时" --scope ../..  # 在祖父目录这棵树里检索
1session index --all --global        # 全库回填索引
(--workspace <path> 是路径形式的旧拼法,仍然可用,优先于 --scope。)
路径从哪来(各家各写各的,读之前先归一):
| Provider | 项目路径 | 时间 |
|---|---|---|
| claude | 目录名 = cwd 的 slug(~/.claude/projects/-Users-me-proj/),每行 JSONL 另带 cwd |
updatedAt = 文件 mtime;createdAt = 首行 timestamp |
| codex | 目录只按日期分(~/.codex/sessions/YYYY/MM/DD/rollout-*.jsonl),路径只在 session_meta / turn_context 的 payload.cwd 里 |
updatedAt = mtime;createdAt = session_meta.timestamp,兜底解析文件名里的时间戳 |
| antigravity | transcript 里没有 cwd,但 IDE 自己维护着项目↔会话的关系:~/.gemini/antigravity/conversations/<id>.db 的 trajectory_metadata_blob 里存着打开的目录(protobuf 字段 1.1,file:// URI;1.2 是外层 workspace 根,1.4 是 git 分支)。读它,读不到才退回从工具参数里猜 |
updatedAt = mtime;createdAt = 首个 step 的 created_at |
| dsh | 目录名是 cwd 的有损编码(- 同时代表 / 和字面 -),只当参考;真 cwd 在开篇 session 记录的 cwd 里。scanRef 只解压文件头 64KB——zstd 帧自带边界,取前缀就等于取会话前缀 |
updatedAt = mtime;createdAt = session.createdAt(epoch 毫秒) |
| grok | 目录名是 cwd 的百分号编码,decodeURIComponent 就能无损还原,所以带 --scope 时可以在开文件之前就筛掉不相干的会话;summary.json 的 info.cwd 是正式答案 |
updatedAt / createdAt 直接取 summary.json;候选发现时的 mtime 取 chat_history.jsonl 与 summary.json 里较新的那个 |
排序和 --since 都只用 mtime,listCandidates() 一次 stat 就够,不必打开文件 —— 打开文件(拿标题、cwd、创建时间)才是贵的那一步,所以它走索引缓存。
Antigravity 的 626 个会话里,本机有 14 个至今没有路径 —— 不是没读到,是 IDE 自己把它们标成了 outside-of-project(开着聊天窗口、没开文件夹时起的会话)。这类会话只在 --global 下出现。
列表为什么是全的
list / workspace / search 都走索引:先对每个会话文件做一次指纹检查(size + mtime + 头部哈希),只有字节动过的才重新解析,然后用一条 SQL 出结果。所以:
- 没有扫描预算,
--scope再大也不会悄悄丢掉更早的会话; - 第一次全量解析本机 625 个会话约 10s,之后每次
list约 0.5s; --no-index仍然可以绕开索引直读源文件,两条路的结果应当逐条一致(可以diff验证)。
升级到这一版后,索引会因为 PARSER_VERSION / EXTRACTOR_VERSION 提升而自动重建一次(新增 grok / dsh 两家,写文件工具表也跟着补了 search_replace 与 run_terminal_command),无需手动清库;想主动做可以跑 1session index --all --global。
<session-id> 支持完整 id、id 前缀(≥6 位)或原始文件路径。
1session workspace . --since 24h --digest --focus marketing
三层下钻——先看全局,再定位到轮次,最后钻进单次工具调用:
1session overview 01a0907c # 第 1 层:这个会话到底干了什么
## 统计
| 轮次 | 事件 | 文件改动 | 命令 | 失败 | 提交 | 产物 | 上传 | 后台任务 |
| 15 | 923 | 15(31 次) | 336 | 27 | 0 | 0 | 0 | 0/0 完成 |
事件构成:user 15 · assistant 89 · thinking 143 · tool_call 338 · tool_result 338 | token:入 51105.9k / 出 185.4k
1session turns 01a0907c # 第 2 层:15 轮,每轮干了什么、花了多久
T 3 2026-09-11T13:03:29 (283s)  事件 29–45  文件 1 · 命令 7 · 失败 0
    ▸ ### 🎉 阶段性重大进展:MiniMax-H3 首次文生视频测试成功落地!…
    ◂ 已经查到一个明确的配置问题:这版 H3 的 `num_inference_steps=4` 实际只执行 3 次去噪…
1session turn 5575981e 1 --event 11      # 第 3 层:单次工具调用的完整输出
1session turn 5575981e 1 --event 11-13   # 连着看:调用 + 结果 + 助理的判断
--event 收 11、11-13、11,15,22 及其混合,一次最多 50 条;区间会按会话长度裁剪,
所以 560-999 就是「看到结尾」。读一次工具调用通常要连读它的结果和后面那条助理判断——
一个进程读完,而不是起三次。
第三层会自动补全被截断的内容:antigravity 的 transcript.jsonl 会把长输出截短(事件 #11 只存了 4092 字符),命令会回读 .system_generated/steps/8/output.txt 拿到完整的 6937 字节并标注 [已从 steps/ 补全];补不回来时如实提示 ⚠️ steps/N/output.txt 不存在。
跨会话检索(--kind 可过滤轮次类型,只看用户说了什么 / 只看工具调用):
1session search "xhs|小红书" --regex --workspace ~/proj --since 24h --kind user
4 处命中,分布在 2 个会话
(已折叠 1 处本次检索自身留下的回声;--include-self 展开)

### antigravity 5575981e  2026-09-13T00:21:05Z → 2026-09-13T03:31:58Z  (2 命中)
  T7 · E318 user  /xhs-tech-card 结合 docs/xhs_sol_h3_spark_output/index.html,第一次实战经验贴。
  T9 · E441 user  /mobile-xhs-publisher
    ↳ 1session turn 5575981e 7 --event 318
事件命中携带 T<轮次> · E<事件号> 和稳定 locator;标题、摘要、产物命中属于会话层,
不伪造轮次。每组附可直接执行的读取命令。
默认折叠本次检索自己留下的脚印:调用方的会话是边跑边索引的,1session search "X" 这条
命令本身(以及它打印出来的东西)会立刻成为 X 的第一条命中。判据只有一条——五分钟内写下的
1session 调用及其结果;只有活着的那个 transcript 才可能有「此刻」的时间戳,所以历史会话一条
都不会被碰到。折叠了多少永远会打印出来,--include-self 可以全部展开。
输出示例(上午 Antigravity 定方案 → 下午 Claude Code 落地实现,自动交织成一条时间线):
# 1agents_app · 跨智能体协作纪实
- 参与智能体:antigravity / claude
- 会话:2 个,统一时间线 12 个节点,涉及 1 个文件

## 统一时间线
- `2026-09-13T03:21:37Z` **antigravity** 提出:在 ./modules/ 创建一个 session-reader 的子模块…
- `2026-09-13T03:27:50Z` **antigravity** write_to_file → implementation_plan.md
- `2026-09-13T03:33:34Z` **claude** 提出:参考 implementation_plan.md,立即开始编码实现!
- `2026-09-13T03:36:52Z` **claude** 失败:src/resolver.ts(38,79): error TS1127: Invalid character.
编程接口
import {
  listRecentSessions,
  findSessionsByWorkspace,
  loadSession,
  parseSession,
  distillSession,
  aggregateWorkspaceSessions,
  searchSessions,
  buildOverview,
  summarizeTurns,
  turnDetail,
  eventDetail,
  eventDetails,
} from '@1agents/session-reader';

const sessions = await findSessionsByWorkspace(process.cwd(), { since: '7d' });
const digest = distillSession(await parseSession(sessions[0].id), { focus: 'marketing' });
const story = await aggregateWorkspaceSessions(process.cwd(), { since: '24h' });
const hits = await searchSessions('小红书', { workspace: process.cwd(), since: '24h', kinds: ['user'] });
const session = await loadSession('01a0907c'); // 走索引;parseSession 直读源文件
const overview = buildOverview(session);      // 第 1 层:overview.stats / overview.markdown
const turns = summarizeTurns(session);        // 第 2 层
const detail = turnDetail(session, 3);        // 第 3 层
const full = await eventDetail(session, 11);  // 第 3 层:未截断的单次工具输出
const around = await eventDetails(session, '11-13'); // 相邻几条一起读
hits[0]?.matches[0]?.turn;                    // 命中所在轮次,与 match.index 凑成 T·E 句柄
searchSessions 另接 selfSessionId 显式指明调用方(默认取 SESSION_READER_CALLER_SESSION);
被判定为「调用方自己」的命中不会被删掉,而是带上 self / suppressed 标记返回,展不展示由调用方定。
aggregateWorkspaceSessions 返回 WorkspaceDigest:sessions / collaboratingAgents /
unifiedTimeline(按时间排序的跨智能体节点)/ fileAttribution(文件 → 谁在什么时候改的)/ markdown。
适合直接喂给下游做小红书笔记、PRD、周报与 changelog,也可零成本包成 DeepSeek Harness(Cordis)插件或 MCP server。
事实的边界:到哪一步为止
(注意与下文「索引」的 L0–L3 不是一回事:那是数据存在哪,这里是事实可信到什么程度。)
| 档 | 内容 | 例子 |
|---|---|---|
| 源文件显式字段 | 各家自己记好的结构化数据,零猜测 | codex CommandExecution 的 336 条命令(带 exit_code/stderr/pid/duration)、FileChange、token 记账;claude 的 gitBranch/model/usage;antigravity 的产物 metadata、上传、任务回执 |
| 确定性规则派生 | 纯规则,可重复、可验证 | antigravity 打印的 The command exited with code N → 211 条 exit_code;ssh user@host → 主机;git commit -m + [branch sha] 回显 → 提交;路径按项目/运行态/日志分组;每个资源的首见/末见轮次 |
| 语义解释 | 本模块不做 | 当前主线、目标漂移、已完成/阻塞/下一步、决策归纳、坑的因果链、资源的 primary/legacy 角色 |
所以 overview 回答的是"最后一条成功命令是什么",而不是"当前阻塞是什么";给出"末态事实"而不是"进度判断"。语义层留白处会显式写明 属语义层,本阶段不生成,不假装。
三级溯源(provenance)
每条事实都带 provenance 与 extractor,回答"你为什么认为这是事实、来自哪个事件、用什么规则提取":
| 级别 | 含义 | extractor 例子 |
|---|---|---|
observed |
provider 自己记的结构化字段 | tool:Write、item:FileChange、item:CommandExecution、receipt:messages |
derived |
对确实执行过的动作施加确定性规则 | shell:redirect、shell:scp、pair:tool_call+tool_result |
candidate |
仅在文本里被提到,没有任何人动过它 | text:path-mention(只出现在「资源」一段) |
1session files 3ab9fe0e --group all
[project] derived   T1 src/types.ts `shell:redirect E42`
[runtime] observed  T5 ~/.claude/plans/codex-01a0907c-….md `tool:Write E206`
[project] derived   T7 src/ledger.ts `shell:redirect E415`
文件账本永远不含 candidate——路径只有在证明发生过写操作后才会进来。「资源」一段是唯一收纳 candidate 的地方,标题里写明了。
先证明发生了文件操作,再抽路径——而不是看到像路径的字符串就当成文件。具体地:here-doc 的正文(正在被写入的数据)在分析前会被剥离,否则里面的源码会伪装成命令——(a, b) => b[1].length 里的 > 会被当成重定向,payload 里的 ssh [email protected] 会被当成真连过的主机。裸 token 还必须带真实扩展名,否则 r.source、a.name 都会被当成文件。
每条事实后面带 Evidence Handle(E<事件号> · T<轮次>),可以直接下钻验证:
1session turn 3ab9fe0e 9 --event 491
同样的原则贯穿每一处:没有证据就不断言。异步作业只在有完成回执时标 completed,否则一律 unknown 并写明依据;没有打印 exit code 的命令结果,exitCode 就是空,绝不补成 0。
三级溯源回答不了的那一问:现在还成不成立
observed / derived / candidate 回答的是这个事实怎么来的,不是它现在还对不对。
overview 的「末态」恰恰是最易腐的一段:
凡是关于当前状态的问题(凭据、环境变量、装了哪个版本、文件还在不在),会话只能告诉你 它最后一次为真是什么时候——去核实。转录记下的是说过什么和退出码,不是效果。
三种真实撞上过的情况:一条命令退出码为 0、无报错,但它读到的是空输入,写进配置的是个空值; 某一轮的结论说「现在存了三份」,其中一份是只活在当时那个 shell 里的临时函数,从没落盘; 「某某已配好」在当时是对的,三周后需要另外验证。会话忠实记录了意图和退出码,记不下效果—— 这是转录这种载体的边界,不是提取规则的疏漏,所以本模块不打算用更聪明的规则去补它, 只把话说清楚。
轮次完成状态
第二层每一轮带一个有证据的状态——只说这一轮有没有收尾,不说做成了什么:
| 标记 | 状态 | 判据 |
|---|---|---|
✓ |
completed | 有原生 task_complete,或以 assistant 收尾且下一轮不是催促 |
⚠ |
unfinished | 有 task_started 但没有配对的 task_complete |
↻ |
nudged | 下一轮是纯推进指令(继续/continue),记连续次数 |
✂ |
interrupted | 轮内有 tool_call 却没有对应结果 |
⊘ |
no_response | 除用户消息外没有任何助理事件 |
✗ |
failed_tail | 以 exit ≠ 0 收尾且其后无 assistant |
多条证据可以同时命中,此时置信度更高。实例:
⚠ T 9 ... [unfinished ×2]
    ! provider 记录了 task_started 但没有配对的 task_complete(turn 01a095f4-5b27);下一轮是纯推进指令,连续 2 次("contin")
这一轮切换到 Sol-H3-Spark 没跑完 → 用户打了 contin → 又打 continue。两条独立证据指向同一结论,不需要模型参与。
设计取舍
- 发现是分层的:先按文件 mtime 排序候选(只
stat),再按需读文件头填充元数据,最后才整篇解析。list与workspace通常在 0.5 秒内返回。 --since的精度:预筛用文件 mtime(可能因同步/复制而失真),--digest会在整篇解析后用真实轮次时间戳再过滤一次。- Claude 标题:
list只读文件头,标题取首个用户请求;inspect/digest/workspace --digest会整篇解析,此时优先使用会话自身的custom-title/ai-title。 search没有扫描上限。早先它受发现层的扫描预算限制,一次查询其实只看最近 ~60 个会话/每个智能体,却把结果报告得像查全了——"静默不全"比慢危险。现在--limit只管返回几个会话,不再兼任"最多检查几个会话";满足--workspace/--since/--provider的会话一个不漏。默认每个会话最多列 5 处命中,totalMatches给的是真实总数。- 文件归属分三级溯源(见上文 provenance)。
observed来自显式写工具(Write/Edit/write_to_file/replace_file_content/apply_patch/grok 的search_replace)与 provider 自己记的FileChange;derived是从 shell 命令里解析出来的(>/>>、tee、cp/mv、scp、sed -i、python 的write_text/open(w))。没有后者,纯靠 shell 干活的智能体(如 codex 全程走exec沙箱)会显示成"一个文件都没改过"。这是启发式,可能漏也可能多报,所以每行都写明是哪条规则提取的。 - 轮次边界按"其后最近开始的那一轮"归属。
task_started总比该轮第一个事件早几秒(12:41:06 vs 12:41:13),按"落在窗口内"匹配会全部落空。 - 统计优先用各家自己记的结构化数据,而不是我们推断。codex 的
event_msg/item_completed里有FileChange(带 diff)、CommandExecution(带 pid/cwd)、task_started/task_complete(轮次边界 + 耗时)与token_usage_record;claude 每条都带gitBranch/model/usage;antigravity 的产物、上传、后台任务分别在 brain 目录、.user_uploaded/与.system_generated/{tasks,messages}/。统计里filesByProvenance给出这次的observed / derived分项计数。 - 轮次边界按时间对齐,不按下标。codex 原生边界(12 个)比用户消息(15 条)少,按下标取耗时会错位。
- token 把缓存复用单列。claude 每次请求的真实
input_tokens平均只有 2,而cache_read_input_tokens平均 30 万(重读整个缓存前缀);把后者计入输入会让一个 20 万上下文的会话显示成 1.16 亿 token。现在input只含真正写入模型的部分,缓存复用记在cacheRead。 - 失败只有一个定义:exit code 明确非 0,或 exit code 未知但 provider 标了错。
stats.errors与1session errors永远是同一个数。 - 文件也只有一个账本。
overview的统计、overview --json的writes、1session files --group all三者行数恒等,且project + runtime + log必须刚好铺满(有测试钉住)。filesChanged是去重后的文件数,fileChangeEvents是写动作次数(同一文件写三次算三次),两者定义不同所以可以不等。混合账本不给单一来源标签,而是给observed / derived的分项计数。 - 远程写会带 host。命令形如
ssh user@host '…'时,其中的写标记为host:/path;但scp remote:src local_dst是往本地写,host 只认目标端自己写明的那个。
索引:把事实存下来,而不是每次重推
~/.1agents/session-reader/index.db(SQLite,SESSION_READER_DB 可改)。任何命令碰到一个会话都会顺手索引它;1session index --all 做全库回填。
L0  各家原始 JSONL                        ← 永远是唯一真相
L1  归一事件  sessions / events
L2  确定性事实  file_ops / commands / jobs
L3  会话关系  session_edges / edge_evidence
四个版本号各管一层(src/store/schema.ts),这是分层的实际收益:
| 变了什么 | 代价 |
|---|---|
源文件指纹 或 PARSER_VERSION |
重读文件,L1/L2/L3 全部重建 |
EXTRACTOR_VERSION |
一个字节的 JSONL 都不读,从 events 行重新推导 L2 |
EDGE_VERSION |
同上,只重推 L3 |
SCHEMA_VERSION |
删库重建(L0 能重建全部,不写迁移代码) |
指纹 = 大小 + mtime + 文件头 64KB 的 sha256。没有"会话是否结束"这个概念——指纹没变就是没变。
事件文本整条存,不截断。曾经按 128KB 封顶,实测代价是全库 622 个会话里只有 7 个事件超限、省下 0.08% 的体积,却让 search 漏掉长构建日志里的命中(--deployment-target 正好落在切口之后)——用 0.08% 换一个"看起来查全了其实没有"的答案,方向反了。本机实测:622 个会话首次回填 7.5s,索引 297MB。
索引只许加速事实,不许改动事实。测试里钉着一条往返等价:三个 provider 各取一个真实会话,parse() 的结果与索引读回的结果必须 deepStrictEqual,buildOverview 的 markdown 也必须逐字相同。命令行上随时可复核:
diff <(1session overview <id>) <(1session overview <id> --no-index)
检索:SQL 出候选,正则下判决
search 不再把 622 个会话还原成对象——那一步比其余所有环节加起来还贵(实测 1.33s)。现在是 SQL 预筛 + 原有正则裁决:
Query
  ↓  planQuery:能不能证明出一个"必然出现"的子串?
SQL  instr() 预筛(外加 workspace / kind / since 下推)
  ↓
现有 regex matcher ← 唯一的语义权威
Hit
分三档:
| 查询 | 处理 |
|---|---|
字面量 src/ledger.ts、会话 |
直接 instr() 预筛 |
正则且能安全抽出必然子串 src/.*ledger\.ts → ledger |
instr() 预筛 + 正则裁决 |
抽不出来 (foo|bar)、\d+\.\d+ |
不预筛,流式扫行 + 正则裁决 |
抽取器故意保守:出现 | 或任何分组就直接放弃;abc?def 只敢claim def(c 可能不存在)。宁可全表扫,也不要一个"看起来搜过了其实漏了"的答案——这和截断上限是同一类错误。
两个必须对齐的细节,都有测试钉住:
- 大小写折叠。
gi正则在非u模式下只折叠 ASCII,SQLite 的lower()恰好也只折叠 ASCII,所以纯 ASCII 字面量可以两边一起折。非 ASCII 则取最长的"无大小写"字符串(CJK 折叠是恒等),用大小写敏感的instr比。 - 预筛按列比,不按拼好的 haystack 比。匹配串一旦跨列就会漏,所以含换行的字面量直接不预筛。
中文不需要分词:instr 是子串匹配,搜「会话」在「跨会话检索」里天然能中——这正是 FTS5 做不到的(unicode61 把整段当一个 token,trigram 要求 ≥3 字符,两者搜「会话」都是 0 命中)。Agent transcript 里大量内容是 session id / 路径 / CLI flag / 变量名 / commit hash,子串语义本来就比 token 语义更贴合。
本机实测(622 个会话):
| 查询 | 改造前 | 现在 |
|---|---|---|
deploy(1631 命中 / 239 会话) |
1.62s※ | 0.47–0.60s |
会话(2336 命中 / 263 会话) |
1.14s※ | 0.35–0.39s |
src/ledger.ts |
1.1s※ | 0.43–0.46s |
※ 改造前那几个数字还只覆盖了 ≤180 个会话。以上都是热缓存;文件缓存冷时首跑约 1.8s,绝大部分花在 622 次 stat 与指纹头读上。现在是全库,而且 search 与 search --no-index 的会话集合 / 命中数 / excerpt / 顺序逐项相同(10 种查询形态验证过)。
会话关系图(L3)
边从真实工具调用里长出来,不猜。B 跑了 1session overview A,就记一条 B --references--> A:
结构化的问题不要走全文检索——L2/L3 有确定答案:
| 问题 | 该查 |
|---|---|
哪些会话文本里提到过 src/ledger.ts |
search |
| 哪些会话确实动过它 | file_ops(1session files) |
谁引用过 01a0907c |
session_edges(1session graph) |
$ 1session graph ca8325e1
  → references    claude:3ab9fe0e… 证据 9 次(overview turns overview files files …)
  → references    codex:01a0907c… 证据 2 次(overview overview)
关系表一条、证据表多条,所以能区分"瞥了一眼"和"全程在消费"。规范方向只存 from=调用方,反向由展示层翻成 referenced_by。
三条硬约束:
- here-doc 正文先剥掉(复用
writes.ts的stripHeredocs)。文档里写着1session overview xxx的代码块不是调用,把它算成边就会凭空造出关系——这和早先把 here-doc 里的r.source、1.2.3.4当成真实文件和主机是同一个坑。 - 目标必须能解析成已索引的会话,否则不落边。悬空边比没有边更糟。
- 幂等:重新索引不会让证据计数膨胀(计数是数出来的,不是累加的)。
本期只实装 references 与 handoff_from;forked_from / resumed_from / sends_to 在类型里预留但从不猜测。
运行时捕获:若环境注入了 SESSION_READER_CALLER_SESSION,调用当下就直接落边(observed / runtime:caller-env),无需事后从历史里恢复。
DSH 插件入口
从 npm 安装到 DSH Web profile(包内声明了 dsh.bundle.patch,安装后自动启用):
dsh plugin --profile web add @1agents/session-reader
只查看历史时安装 @1agents/session-reader 即可;插件按请求查询 ACP 服务,不把 ACP 注册为加载依赖。从 DSH 源码仓库运行时在命令前加 pnpm;桌面版将 profile 改为 desktop。更新包后重启对应的 DSH 服务。需要续聊时另运行 dsh plugin --profile web add @1agents/acp-service。使用统一包 @1agents/acp-service@>=0.5.0 时,插件默认自动启动或复用本地 ACP 服务,无需另开终端;远程地址或 serviceMode: external 仍由外部管理。具体配置见 ACP 插件说明。
DSH 侧栏中的「历史会话」打开跨 Agent 会话浏览器。入口沿用「插件」「自动化任务」的主文字色、字号、行高、圆角、悬停与键盘焦点样式;展开时使用 16px 图标,折叠时使用 18px 图标和 36px 按钮,颜色跟随 DSH 的亮暗主题。
在 DSH 中继续原会话
安装并启用 @1agents/acp-service 的 DSH 插件,启动其配置的 acp-service 后,Claude、Codex、Grok 的历史详情提供「在 DSH 中继续原会话」。session-reader 读取历史并调用 ACP 插件的 oneagentsAcpSessions 服务;1acp 恢复原 Agent 的原生会话,后续输入继续发给它。原工作目录必须存在;不会改用当前目录或新建空会话。DSH 来源直接打开原有 DSH 会话,不复制或重写日志。
ACP 未安装、Agent 未就绪或来源不支持时,历史仍可只读查看。导入、鉴权和恢复失败会显示原因并保留预览。重复导入打开同一个 DSH 会话;导入历史是一次性快照,不持续同步其他客户端新增的消息。旧版导入产生的历史副本不会自动改绑。外部工具调用与结果保留为只读历史记录,不触发 DSH 工具执行。
session_open_in_dsh 和 POST /api/session-reader/open-in-dsh 共用同一入口,接受 sessionId(ID、前缀或原始文件路径)和可选的 provider;provider 用于区分不同来源的同名 ID。外部成功结果包含 dshSessionId、workspace、workspaceId、agent 与 continuation: "native",DSH 来源返回 continuation: "dsh"。GET /api/session-reader/continuation?provider=codex 返回续聊可用性及不可用原因。独立 CLI、解析库与历史搜索不需要安装 ACP 插件。
验证当前 DSH 事件兼容性:先运行 npm run build,再运行 node scripts/check-dsh-import.mjs /absolute/path/DSH(DSH checkout 须已构建)。test/fixtures/dsh-import/ 保存用户消息、思考、工具调用与结果,以及未完成尾部的固定历史快照。
1session web:独立浏览器
前端用于找到并确认关键对话,再把准确引用交给 agent。支持按工作区、Agent 来源、更新时间和内容范围搜索, 展示多个命中片段并高亮关键词,点击直接定位原文。会话和消息都可复制引用;复制内容包含完整会话 ID、 消息 locator(或工具调用 / 产物路径)、原文片段与 CLI 读取命令。组合检索和跨 Agent 交接由 CLI / 工具入口承担。
没有 DSH 也能看同一套历史会话列表、对话预览和文件账本:
1session web                 # http://127.0.0.1:7780
1session web --open          # 启动后打开默认浏览器
1session web --scope global  # 默认列出全部工作区
列表只拉元数据并支持加载更多;点击会话后先读取轮次目录,再按轮次与游标读取原文,可补充前后轮次。
文件、产物和会话统计放在可收起的辅助详情中,工具记录按轮次折叠。这和 1session serve(DreamMate Network 的 JSON 服务)不是同一件事。
1session serve:接入 DreamMate Network
把本地 Read Plane 原样暴露成网络能力——1session overview <id> 成为 sessions.read。
不重新实现索引与事实层,只是换一个调用入口。不引第三方 HTTP 框架,只用 node:http。
1session serve                                  # 默认 127.0.0.1:7777
1session serve --host 100.x.x.x --token <t>     # 暴露到 tailnet
启动时默认向本机 node agent(36908)报备,
--no-report 可关。agent 没起时是静默 no-op,不影响本服务——只是外部得靠约定端口
碰运气找它,而不是探一个 36908 就看见。报备会如实声明可达性:--host 是回环就报
localhost(外部发现得了但连不上),否则报 network。
端口 7777 是 L0 协议 的约定端口
(DEFAULT_PORTS['session-registry']),不是随手挑的:发现是 pull 的——
Control Plane 从 tailnet 拿到节点后,照着这张表探测 /manifest 与 /health。
换成别的端口就探测不到了,得由服务自己 POST /nodes/register 告知。
GET /manifest 只报本服务自己(节点全貌在 agent 的 :36908/manifest)
GET /health
GET /v1/sessions ?limit&scope&since&provider
GET /v1/sessions/:id 会话概要
GET /v1/sessions/:id/turns 逐轮概要
GET /v1/search ?q=&scope=&since=&limit=&provider=&kind=®ex=&case=
GET /v1/graph/:id 会话之间的引用关系
声明的能力:sessions.list sessions.read sessions.turns sessions.search sessions.graph。
每个会话都带上网络内的地址:
session://<node>/<runtime>/<session_id>
session://Scott-Mac.local/claude/87f7a60a-a86e-49c5-b711-e463156a5420
跨机实测(Windows 节点读 Mac 的会话,全程没有 Control Plane 参与):
scott-pc$ curl http://scott-mac.tailfb4720.ts.net:7777/v1/sessions?limit=3
{ "node": "scott-mac",
  "sessions": [ { "uri": "session://scott-mac/claude/87f7a60a-…", … } ] }
读取即落边。 请求带 X-Caller-Session: <调用方会话> 时,读取当下就写入
调用方 --references--> 目标,与 CLI 的 SESSION_READER_CALLER_SESSION 是同一条路径。
两端都必须是本地已索引的会话,否则静默跳过——悬空边比没有边更糟。
节点身份由 @1agents/dreammate-node 统一提供
(优先 tailscale status --json 的 Self,缓存 60s):它是每台机器的公共事实,
本机所有服务读到同一份,不会各自生成 id 把一台机器裂成几个 Node。
node_id   nigVtDS1s521CNTRL                            ← tailscale ID,重启不变
name      scott-mac                                    ← DNSName 前缀
type      macos                                        ← 由 tailscale 的 OS 映射
base_url  http://scott-mac.tailfb4720.ts.net:7777/v1   ← MagicDNS,跨机可直接用
⚠️ 名字取 DNSName 而不是 HostName 是有原因的:iOS 设备的 HostName 全是
localhost(实测 11 个节点里只有 9 个唯一),几台手机接进来会产出 一模一样的session://localhost/yima/...。DNSName 实测 11/11 唯一且可读。
没装 / 没登录 tailscale 时静默回退到本地身份(hostname + 首次生成的 uuid,
存在 ~/.1agents/node.json)。回退身份的 name 不保证跨设备唯一,只适合单机自用。
manifest.metadata.identity_source 会如实报告身份来自 tailscale 还是 local。
DREAMMATE_NODE_ID / DREAMMATE_NODE_NAME 覆盖一切(容器或同机第二个实例用)。
只读、且默认只监听 loopback。 会话原文含源码、shell 历史和恰好滚过屏幕的密钥,
所以走出本机必须是一个刻意动作:显式 --host,并且最好配 --token(Authorization: Bearer)。
非 loopback 且无 token 时启动会告警。非 GET 一律 405。
协议定义来自
@1agents/dreammate-network(L0)。src/serve/node.ts直接 import 它的类型,不再本地抄一份——单向依赖 L2 → L0 是允许的, 而共用同一份定义才谈得上「公共语言」。schema 是唯一事实源,改类型先去改那个包。/manifest的metadata.protocol_version报告本服务遵循的协议版本。
SQLite 的 TEXT 列会在 NUL 处截断
存进去 A<NUL>B,读出来只剩 A——不报错,安静地丢掉后面全部内容。
实测一个 antigravity 会话里 wsl -l -v 的 UTF-16 输出被当 UTF-8 读,产生交错
的 NUL,502 字符的 tool_result 存完只剩 342,后面 160 个字符凭空消失。
改存 BLOB 能保真,但 text / tool_result 上有 SQL 搜索(LIKE 对 BLOB 不
工作),所以走写入转义、读取还原(src/store/nul.ts)。引导符用 U+FFFF:
Unicode 明确规定的 noncharacter,不会出现在有效文本里;万一真出现也会被双写,
还原无歧义。绝大多数内容两个字符都不含,直接原样返回,常态零开销。
这类 bug 的可怕之处在于没有任何报错——只有 round-trip 测试
(readSession(db,row) 深度等于 adapter.parse(candidate))能抓到它。
那条断言就是整个索引层的安全网:一旦索引在改写事实而不是缓存事实,它就会红。
测试
npm test        # node --test,针对本机真实会话文件;无对应会话时自动 skip
npm run typecheck
发布
npm 包为 @1agents/session-reader,由 GitHub Actions 发布,本地不手工 npm publish:
.github/workflows/ci.yml—— push 到main与 PR 上跑typecheck/test/build/npm pack --dry-run。.github/workflows/release.yml—— 手动触发(Actions → Release → Run workflow),输入patch/minor/major/prerelease或具体版本号。流程:跑测试 →npm version打版本提交与 tag →npm publish(带 provenance)→ 推送 commit 与 tag → 从 npm 下载同一精确版本的 tarball、校验 registry 的 SHA-512 integrity → 创建带.tgz和SHA256SUMS附件的 GitHub Release。
安装兜底:从 GitHub Releases 选择带附件的版本,下载 session-reader-<version>.tgz 与 SHA256SUMS,校验后安装:
shasum -a 256 -c SHA256SUMS
dsh plugin --profile web add ./session-reader-<version>.tgz
将 <version> 替换为所下载的版本;旧 Release 可能没有附件,应使用 npm 安装。附件使用 npm 已发布的同一份字节,不以 GitHub 自动生成的源码归档代替可安装包。
发布顺序是先 publish 再 push:npm 发布失败时远端不会留下悬空的版本提交和 tag,直接重跑即可。
仓库需要配置 secret NPM_TOKEN(npm 上具备该包发布权限的 Automation token)。