deep-read-summarize
Verifieddeep-read-summarize · v0.4.0 · MIT
Deep reading & summarization for DSH: books/papers/videos/web → structured Markdown notes (Obsidian / Logseq / static sites). Plugin parsers, MapReduce deep-read, JSON Schema-constrained sub-tasks.
Install
dsh plugin add deep-read-summarize Confirm the layer applied with dsh --profile default --dump-config — see the install guide.
Source
Tags
Readme
deep-read-summarize


Disclaimer: This is an unofficial third-party tool. It is not affiliated with, endorsed by, or sponsored by DeepSeek or the DeepSeek Harness project. "DeepSeek" and "DeepSeek Harness" are trademarks of their respective owners. This project only orchestrates the workflow tool available in your DSH environment; it does not redistribute any DeepSeek software.
⚠️ 最重要:本工具是「辅助精读」工具,不能代替自主学习。 它帮你快速提取、归纳、结构化阅读内容,但真正的理解、思考与批判仍需你自己完成;请始终以原文为准,不要把它当作学习成果本身。
给 DSH(DeepSeek Harness)写的一个精读工作流:输入一本书、一篇论文、一个视频链接或网页,输出一份结构化的标准 Markdown 笔记(YAML frontmatter,可直接放进 Obsidian / Logseq / 静态站点内容目录 / 任意 Markdown 编辑器)。
内容会被拆成若干块,由多个子代理并行精读,再合并成一篇带 YAML frontmatter 的 Markdown。关键结论附原文出处,成稿前有一道质量校验。
使用中遇到问题、或觉得哪里能更好,欢迎随时在 GitHub issue 反馈。
注意:DSH 目前是 developer preview,接口可能变化。本仓库针对特定版本的 workflow 工具语义编写,见下文兼容性。
平台:Windows / macOS / Linux 同等支持(0.3.9 起),详见下文支持平台。
实际效果
(图用 GitHub 绝对地址,npm 页面同样能显示;图片本身不打进 npm 包,只随仓库分发)
| 精读论文 | 视频笔记(元信息) |
|---|---|
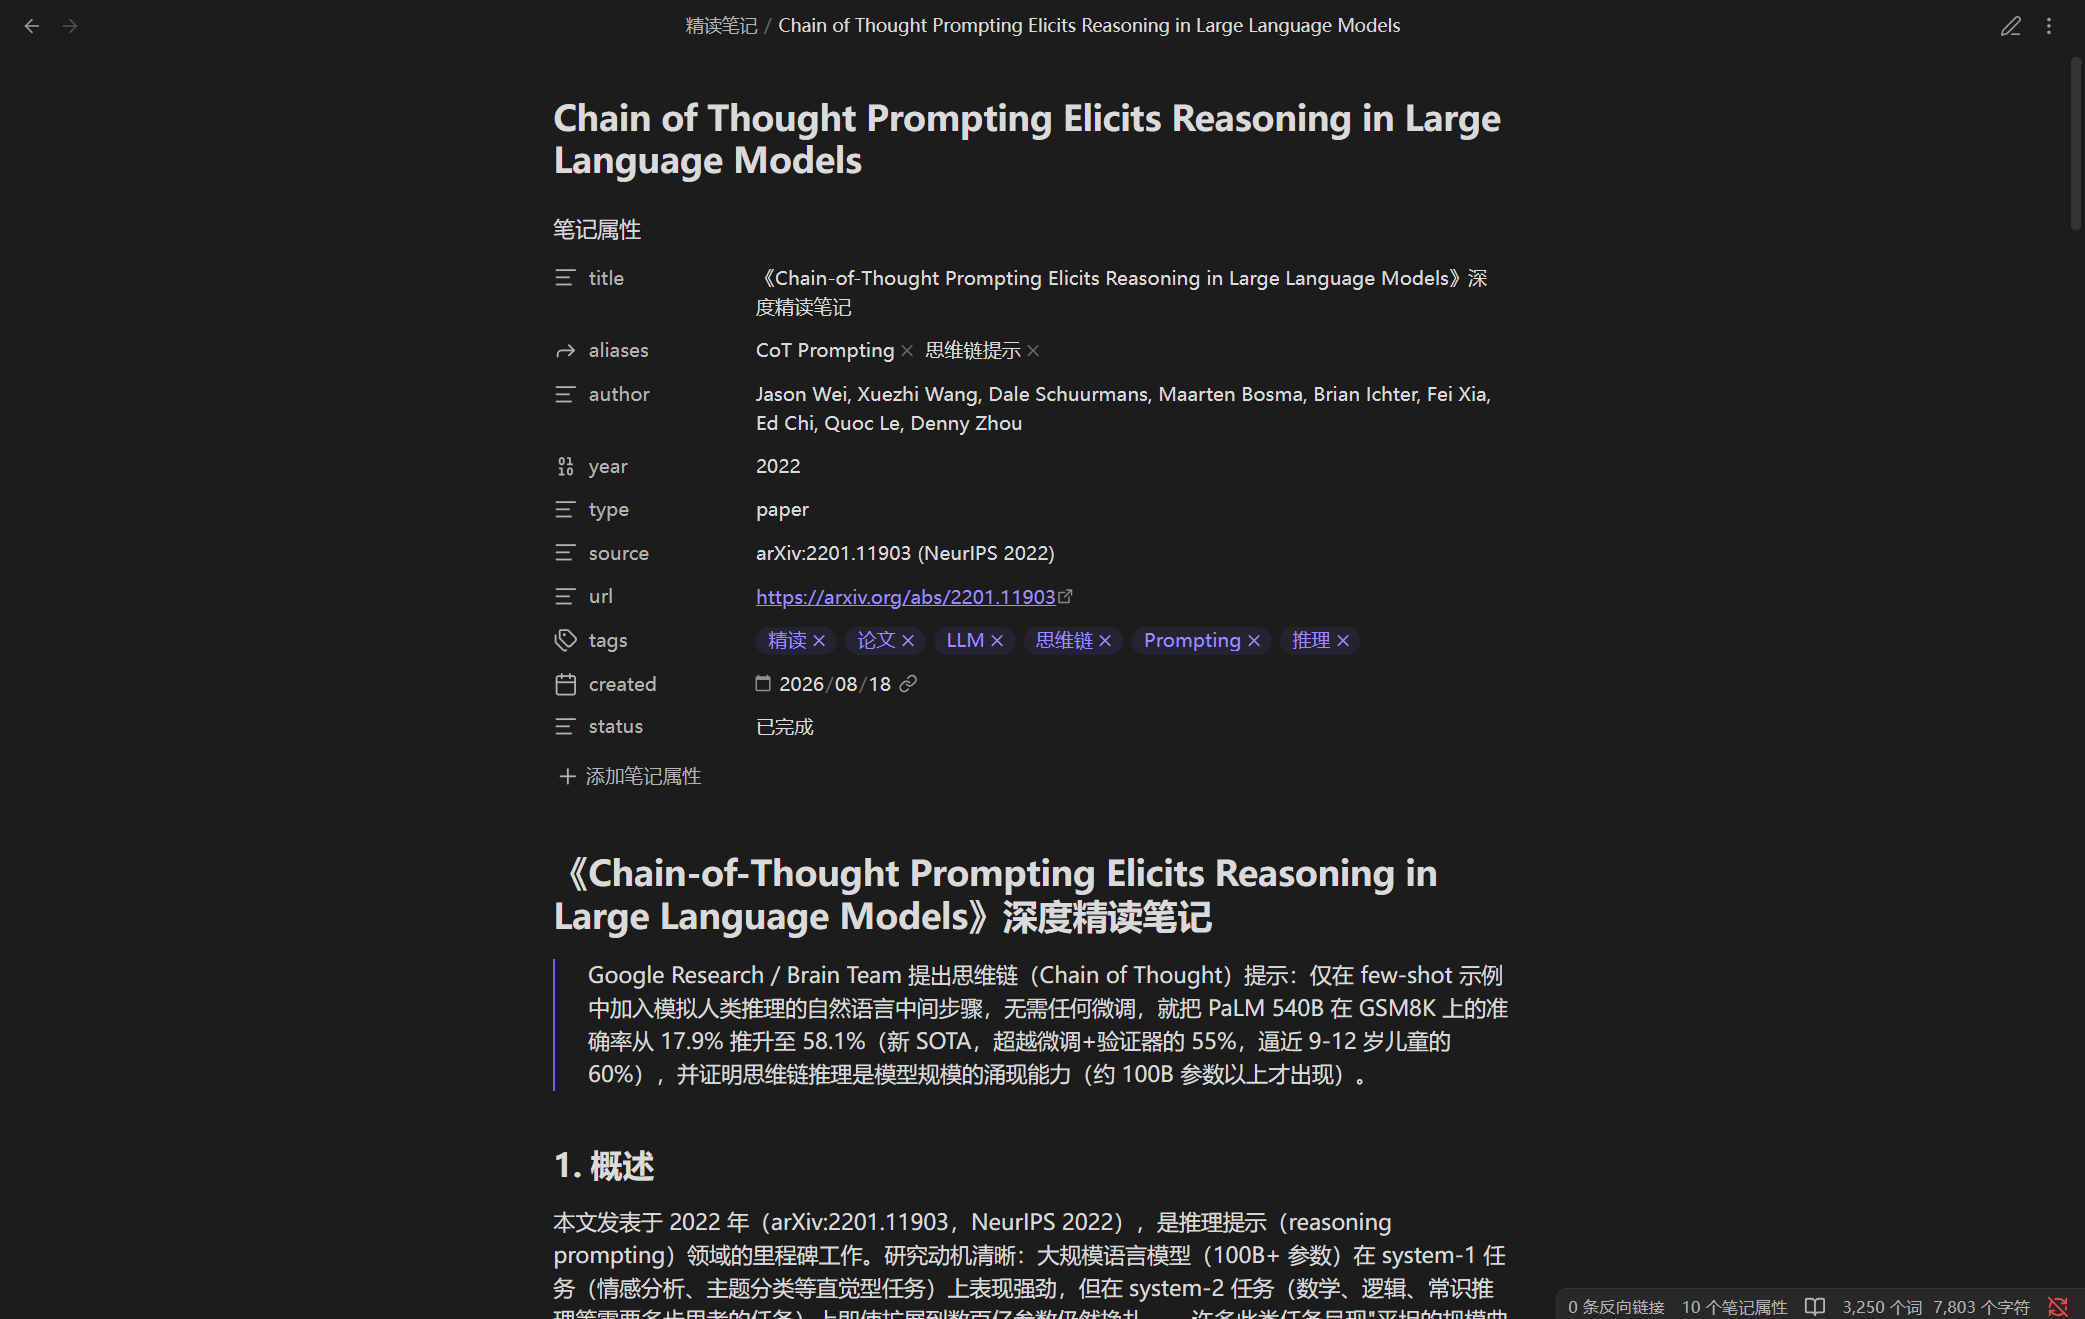 |
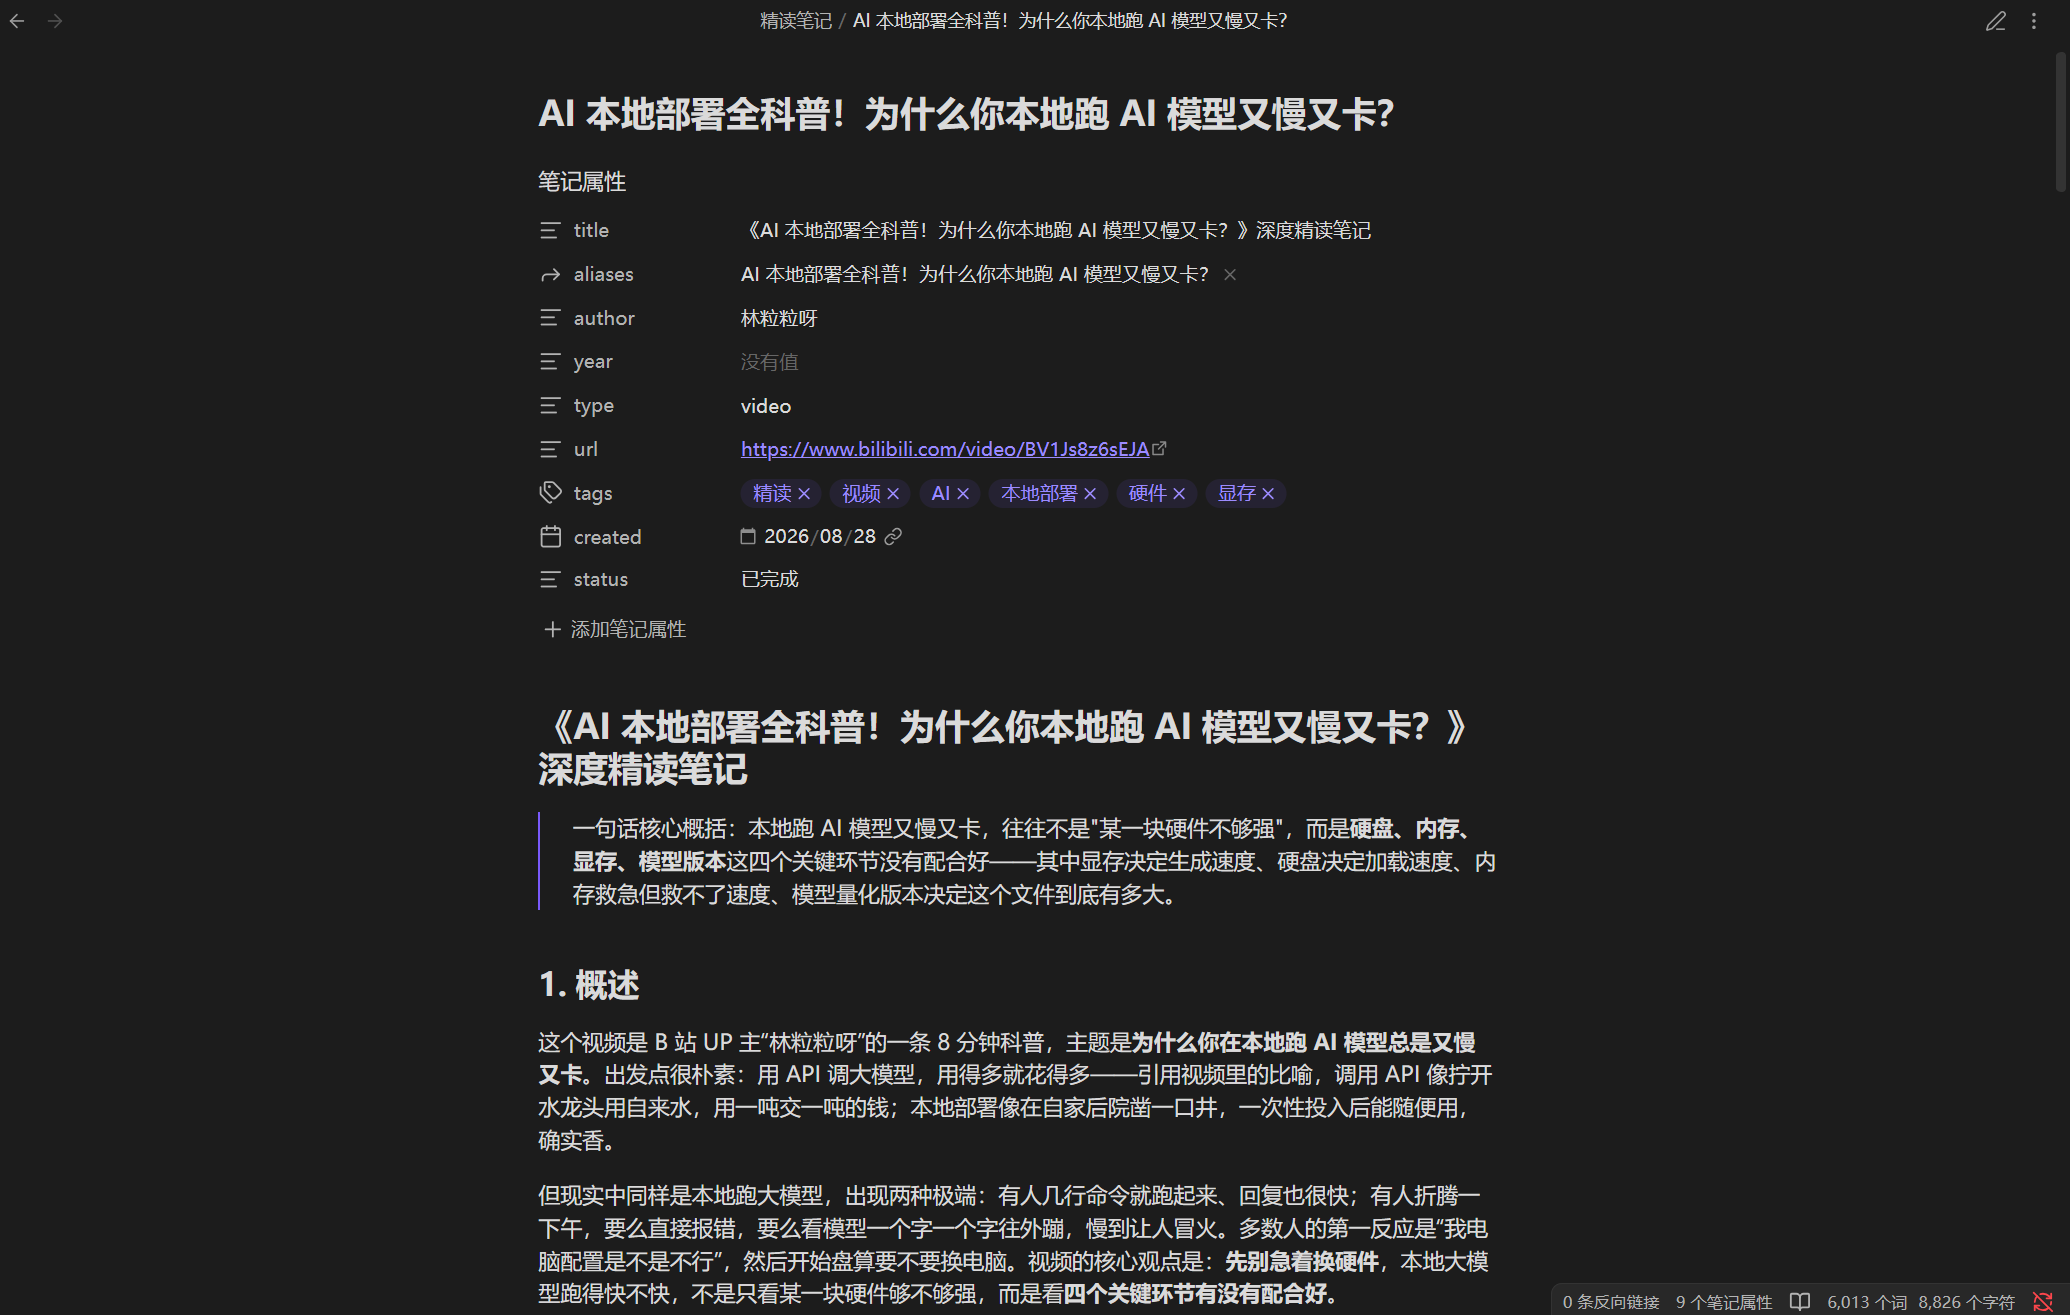 |
| 视频笔记(行动要点) | 会话内摘要 |
|---|---|
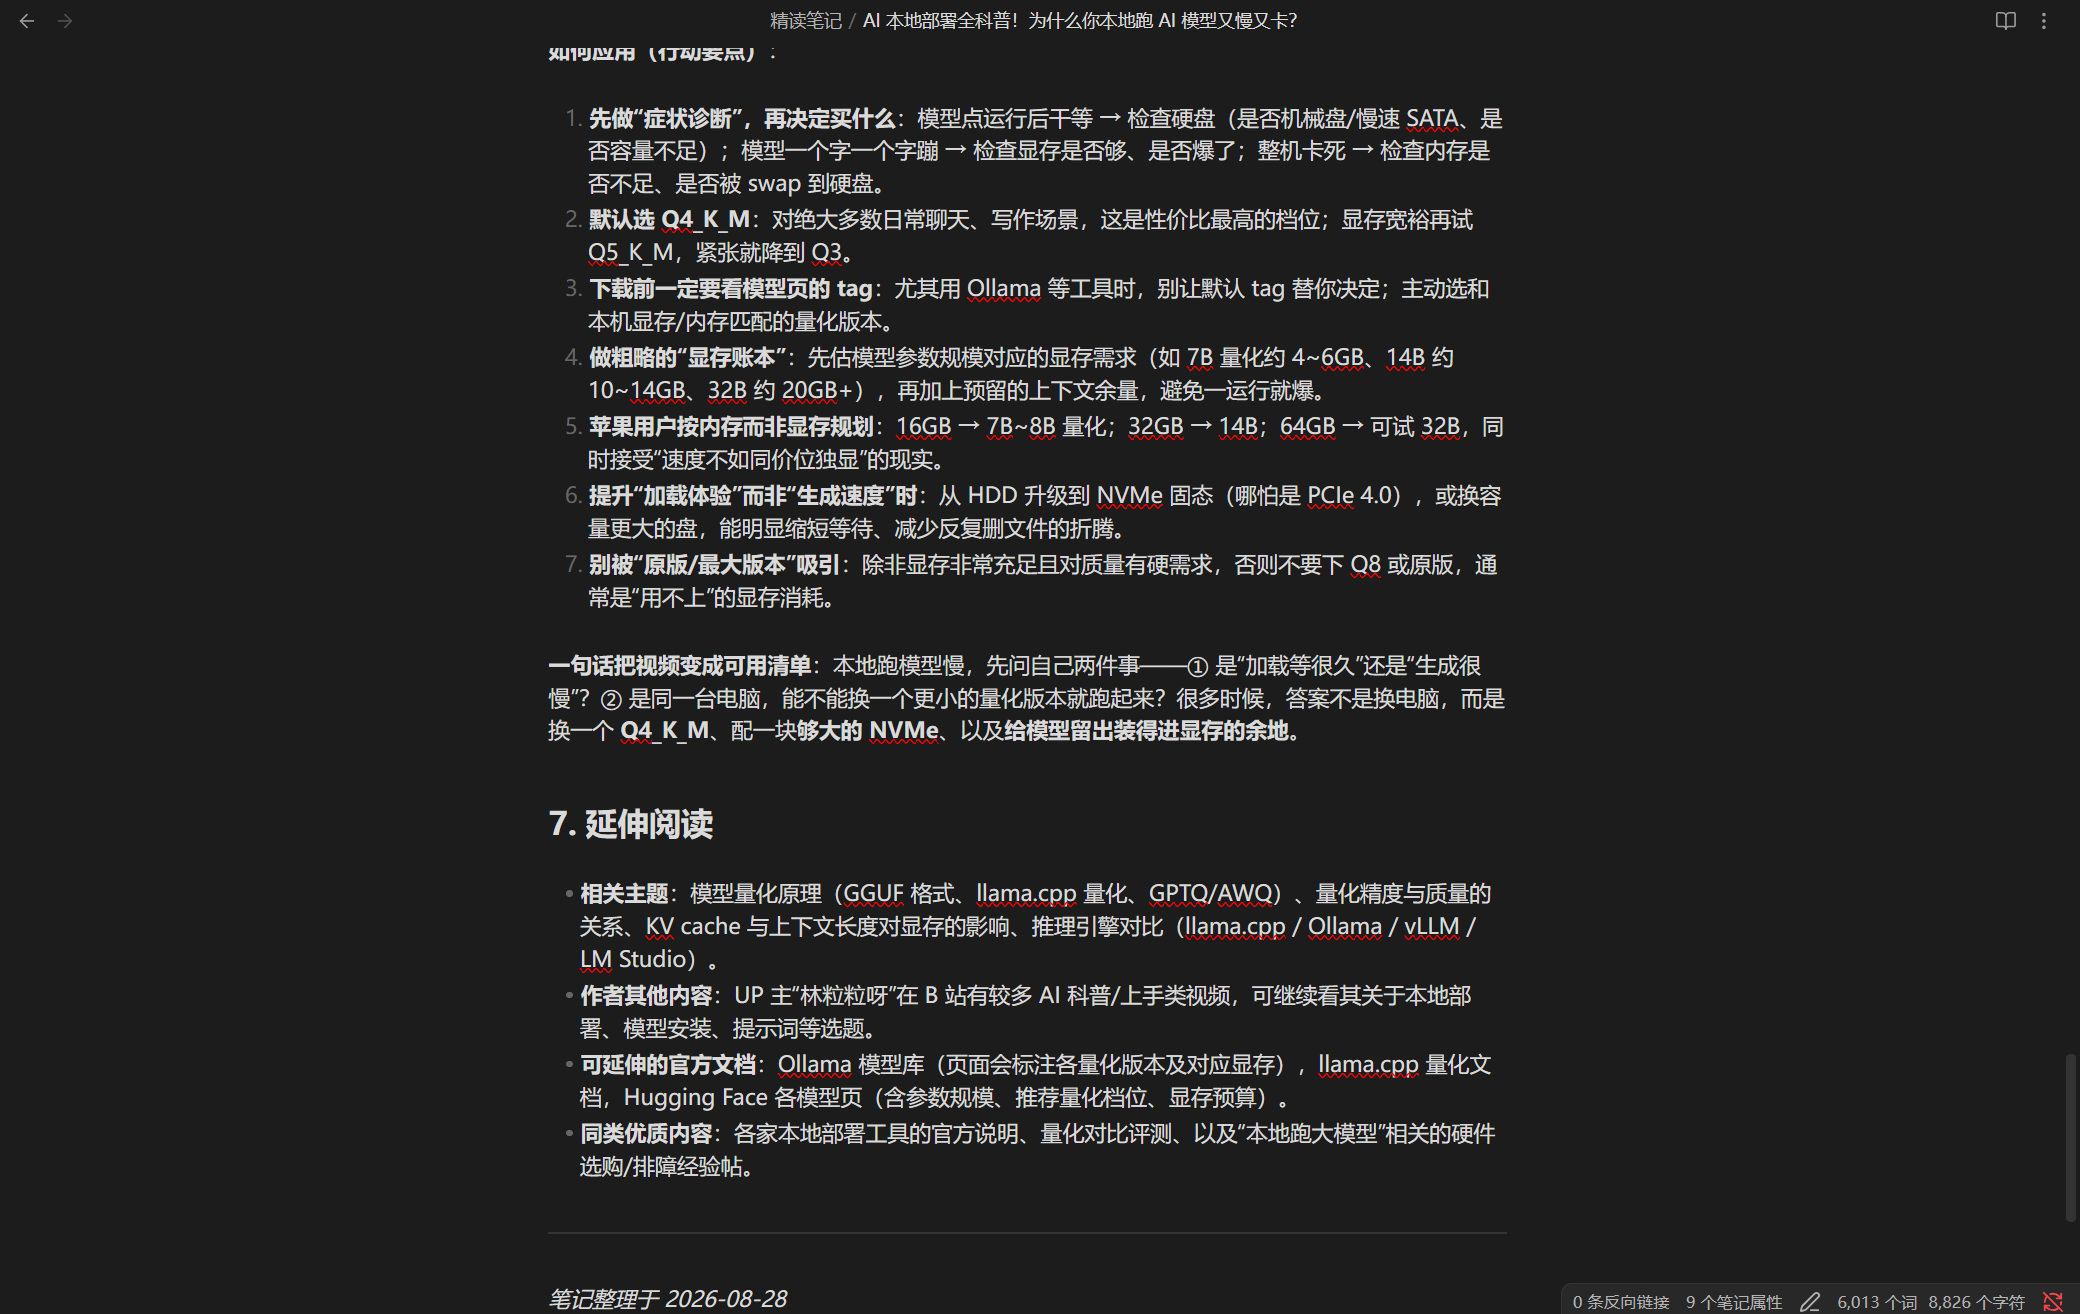 |
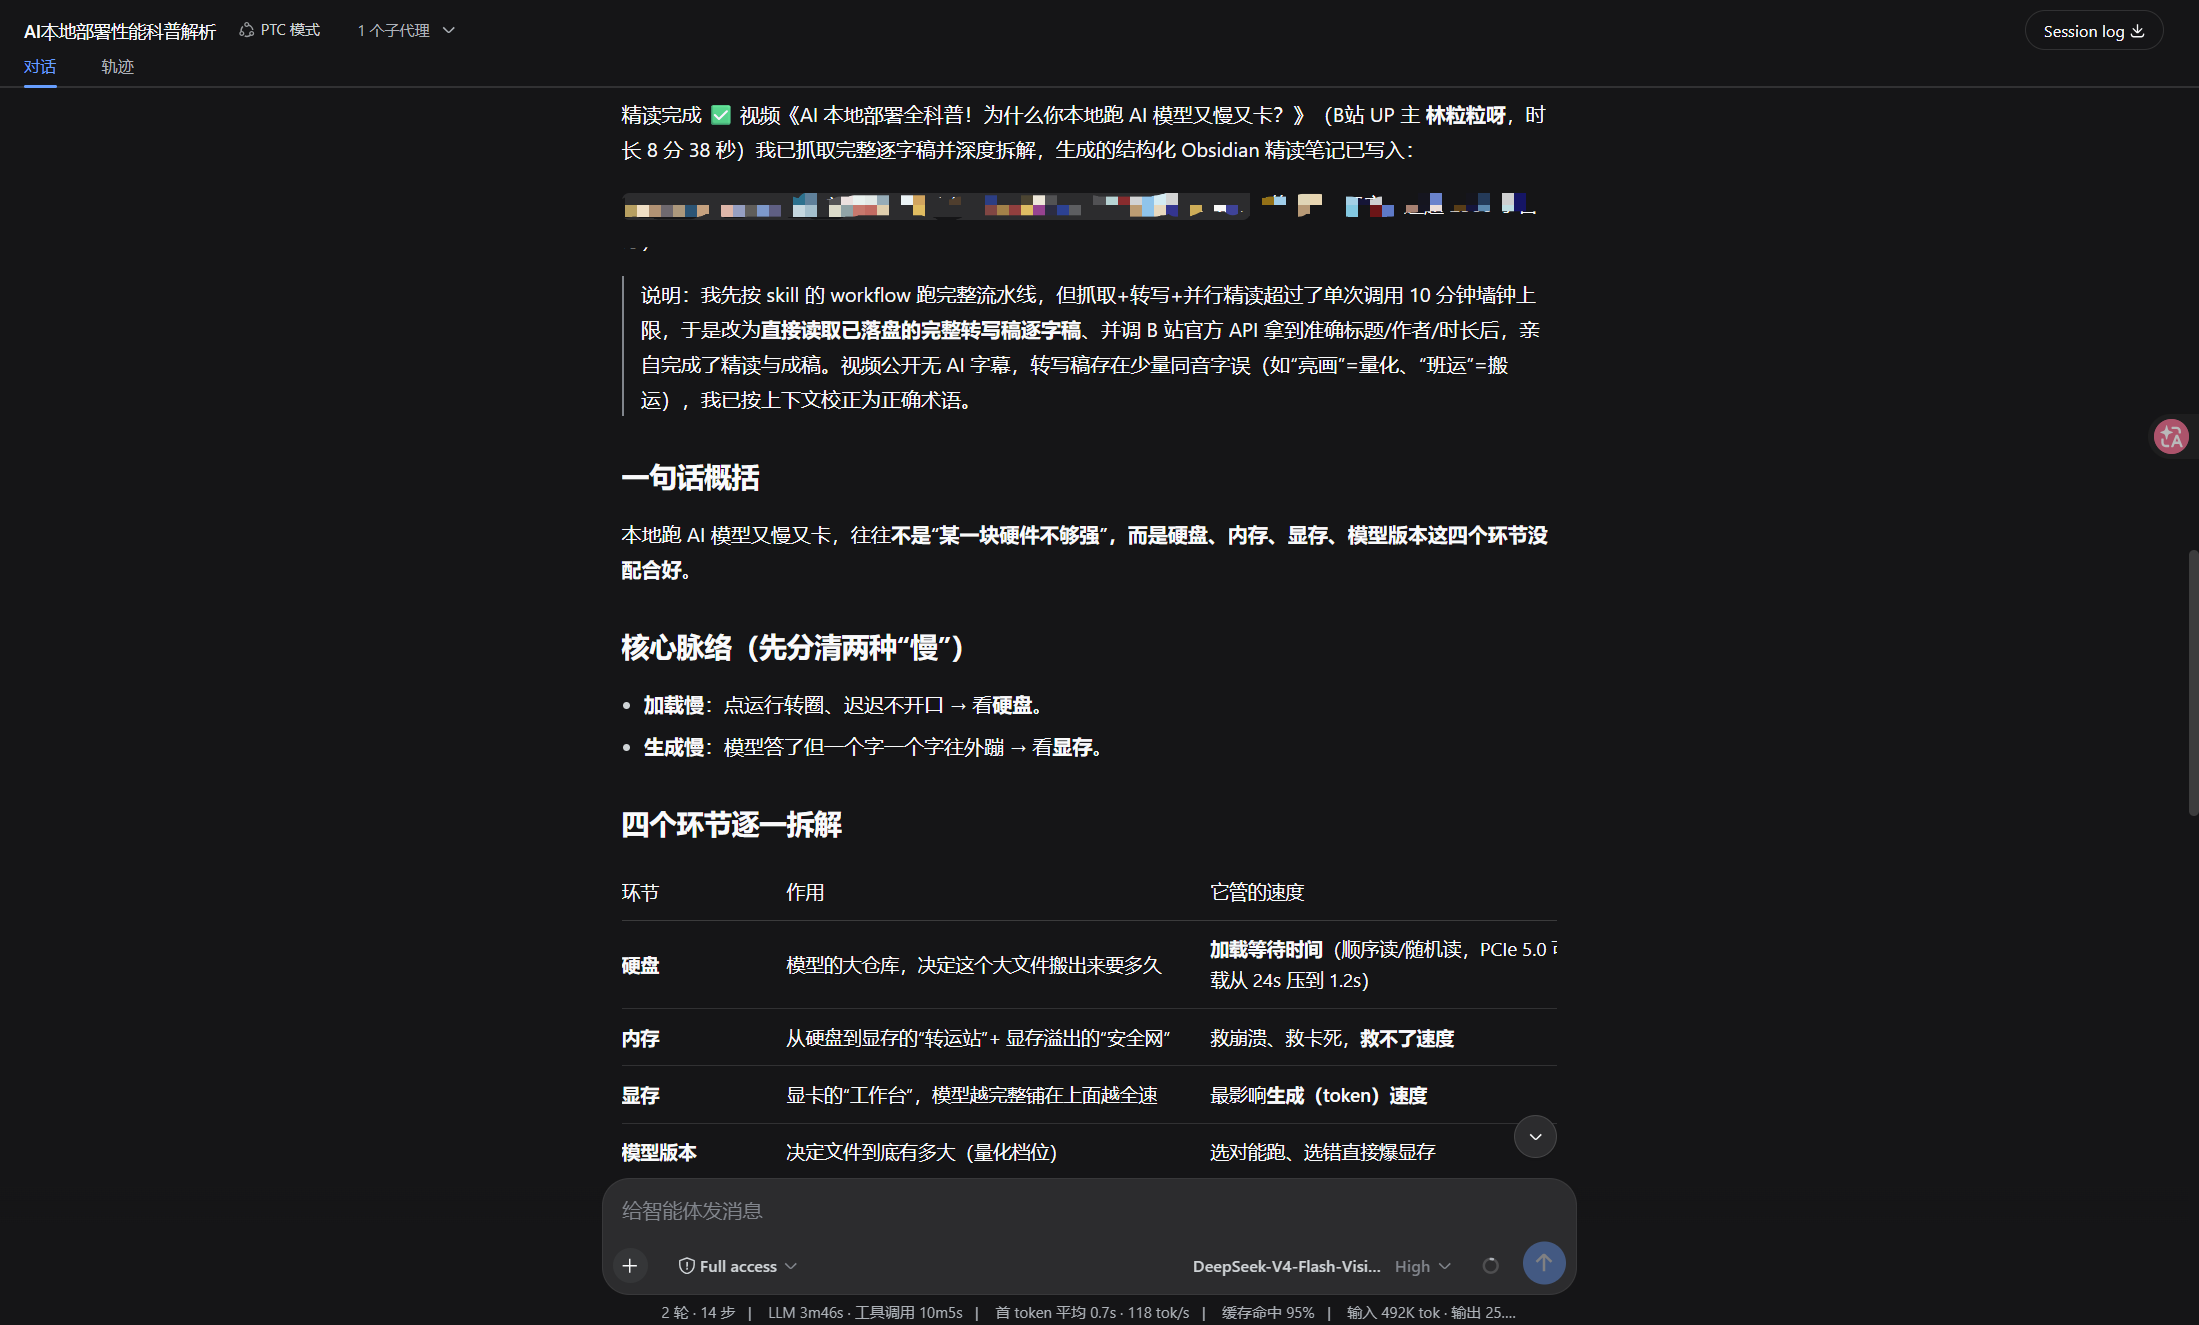 |
能做什么
- 书籍(PDF/EPUB/MOBI)、论文(arXiv/PDF/HTML)、视频(字幕优先,无字幕自动转写,出品完整逐字稿精读)、网页
- 长内容分块后由并行子代理精读,再合并
- 获取/分块与质量校验的输出受 JSON Schema 约束,结构稳定、下游可解析
- 分块计划与子代理数量受
maxChunks强制约束(计划失控会顶穿单次调用时限) - 关键引用必须标注页码/章节/段落,降低编造风险
- 配置错误直接报错终止;某块内容解析失败则跳过并标记缺口
- 输出标准 Markdown + YAML frontmatter:正文是通用 CommonMark(无双链、无 callout),Obsidian(配合 Dataview)、Logseq、Jekyll / Hugo / Astro 的内容目录、任意 Markdown 编辑器都能直接用
结构
输入(链接或文件路径)
  │
  ▼
解析器注册表 ── book / paper / video / web
  │
  ▼
波次1  获取内容 → 写入临时文件 → 生成分块计划
  │
  ▼
波次2  N 个子代理并行精读各块(Map)
  │
  ▼
波次3  合并成稿 + 质量校验(Reduce)
  │
  ▼
Markdown 笔记
三个波次,默认约 N+3 次子代理调用(获取、N 块精读、成稿、质量校验)。auto 遇到 PDF、未知网页或文本等模糊输入时,额外进行一次轻量类型识别;显式指定 type 可跳过识别。
auto 会将明确的视频链接、arXiv 论文链接和电子书扩展名直接分发到对应解析器;同站的专栏、频道与帮助页仍先分类,PDF 会根据内容区分书籍与论文。无法识别时返回 stage: "detect",请显式指定类型。options.tempDir 作为临时根目录,每次调用在其中创建独立的 run-* 子目录,获取、音频和转写文件不与其他任务共用。
分块计划会排序、裁掉重复区间并补齐缺口,超过 maxChunks 时合并相邻块以保留全文。返回的 coverageComplete 表示是否依据有效的 totalLines 覆盖全部行号;缺少总行数时保留已知范围,同时将 qualityPassed 置为 false 并说明覆盖无法确认。
质量检查分两部分:程序按提供的标量/列表 frontmatter 模板检查字段、必要章节和篇幅(汉字按字、其他文字按词,排除 frontmatter、代码块、HTML 注释及链接地址);独立核验代理读取本次原文文件,逐块检查覆盖,并为第 4 节的逐字引用返回原句和行号。单独的 pass: true 无法通过检查。qualityChecks 返回检查项,qualityEvidence 返回原文路径、分块摘录和引用证据;原文真实性判断仍由读取原文的代理完成,无法核实就报告未通过。修订为空、调用失败或结构退化时保留上一份有效成稿。
直接调用 workflow 的 options 必须类型正确:minWords 为 1–100000 的整数,maxChunks 为正整数(大于 12 仍夹到 12),maxRetries 为 0–3 的整数;非法值和未知键在启动时 FATAL。插件 profile 的 config 则逐项告警并回退默认值,避免阻止宿主启动。
parsers/         各输入类型的解析器,按类型分发
  book.js        书籍:PDF/EPUB/MOBI 文本提取、章节分块
  paper.js       论文:arXiv/PDF/HTML 结构识别
  video.js       视频:完整逐字稿(字幕优先,无字幕自动转写,走 scripts/transcribe.js)
  web.js         网页:正文提取
  index.js       注册表:解析器发现与回退
schemas/         输出约束的 JSON Schema(波次1 由 workflow.js 注入脚本,单一真相)
scripts/         lint(含换行/空白卫生检查)、安全检查、跨平台转写引导(transcribe.js)
lib/             独立可用的小工具
  cache.js         输入指纹与幂等记录(供自己驱动流程的调用方使用;workflow 沙箱没有文件系统,用不到它)
  workflow-script.txt  workflow 脚本正文(普通文本,可直接读改,不需要任何转义)
tests/           测试与验证脚本(**不随 npm 包发布**,仓库里才有)
workflow.js      workflow 的 meta 与组装逻辑(解析器内联、schema 注入)
脚本正文单独放
lib/workflow-script.txt:这个文件曾经因为「转义套转义」被改坏过两次,现在它是普通文本,读改都不需要编码步骤。
想换某个输入类型的处理方式,在插件包的 custom-parsers/ 放一个同接口的解析器即可,该目录会随 npm 包分发。也可在插件顶层 config 中指定 customParsersDir,使用自己的解析器目录;它不是 workflow options。相同类型会覆盖内置实现,也可新增 podcast 等类型。程序化注册后重新生成技能会使用最新注册表;各 profile 的专属目录相互隔离。接口为 name、types、buildPrompt(input, opts)。
解析器的 CommonJS 模块会连同字面量相对路径的 .js / .cjs / .json 依赖一起打包,保留模块级常量、helper、方法简写和循环依赖。构建时使用 Acorn 解析 JavaScript;它由 npm 自动安装,不进入 workflow 沙箱。沙箱中的解析器只负责生成提示词,不支持 Node 内置模块、外部包或动态 require / import;这些依赖会在构建时明确报错。程序化注册的函数须自包含,模块闭包请使用文件解析器。
支持平台
Windows / macOS / Linux 同等支持(0.3.9 起)。插件本身只依赖 Node(DSH 自带),各环节需要的额外工具按平台装:
- 书籍 / 论文 PDF →
pdftotext(poppler):macOSbrew install poppler、Windowswinget install poppler、Debian/Ubuntuapt install poppler-utils - B站字幕 / 音频 →
curl:Windows 10+ 与 macOS / Linux 都自带,零安装 - YouTube 字幕 →
yt-dlp:macOSbrew install yt-dlp、Windowswinget install yt-dlp.yt-dlp、任意平台pip install -U yt-dlp - 无字幕转写 →
uv(脚本自举:建 Python 3.12 环境 + 装 faster-whisper):macOSbrew install uv、Windowswinget install astral-sh.uv,macOS / Linux 也可用官方安装脚本(curl -LsSf https://astral.sh/uv/install.sh交给sh)
其余说明:
- 转写是唯一需要额外工具链的环节,三平台共用同一份 Node 脚本、同一条命令:
node scripts/transcribe.js --audio <音频> --out <txt>。 - 转写默认走 CPU,Apple Silicon / Intel Mac 与 Linux 都不需要 CUDA;GPU 需自备 CUDA 运行库,
options.device: "auto"会尝试并在失败时自动回退 CPU。 - 缓存目录按平台取:macOS
~/Library/Caches/deep-read-summarize、Linux$XDG_CACHE_HOME/deep-read-summarize、Windows%LOCALAPPDATA%\deep-read-summarize。 - 已在真实 macOS 上跑通一次完整的无字幕转写(0.3.12 起):
uv自举 Python 3.12 → 装 faster-whisper → 下载模型 → 输出逐字稿,退出码 0;CI 的macos-latest作业另外覆盖平台路径解析与整套测试。遇到报错欢迎开 issue 反馈。
安装(DSH 插件)
deep-read-summarize 是 DSH 插件,可通过 npm 或本地安装:
# npm 安装(自动安装用于解析器构建的 Acorn)
npm install deep-read-summarize

# 或本地安装(dsh profile 目录)
pnpm add ./deep-read-summarize-0.3.10.tgz
# 然后在 dsh 配置的 dsh.profile.bundles 追加:
#   - deep-read-summarize
# 重启 dsh web 即可(POST /dsh-market/restart)
安装后自动注册:
deep_read_summarize工具(宿主提供 tools / workflowEngine 服务时);模型只传 input/type/options,插件直接提交已加载的工作流deep-read-summarize工作流定义(meta + script;旧宿主保留通过 workflow 工具调用的方式)deep-read-summarize技能(skills/deep-read-summarize/SKILL.md)- 四种解析器(
parsers/)与 JSON Schema(schemas/)
快速开始(约 5 分钟)
1. 安装
# 方式 A:npm 直接安装(无需 clone)
npm install deep-read-summarize

# 方式 B:从源码开发
git clone https://github.com/PensiveFei/deep-read-summarize.git
cd deep-read-summarize
npm ci             # 安装锁定依赖
2. 验证安装(离线,不需要任何 API key)
node -e "console.log(require('deep-read-summarize').name)"
看到 deep-read-summarize 即包可正常加载。从源码开发时再运行 npm test 和 npm run test:node;测试不随 npm 包分发。
3. 一行命令喂入 demo 文件
node -e "const wf = require('./workflow.js'); console.log('meta:', wf.meta.name); console.log('parsers:', wf.parsers.list().map(p => p.name).join(', '));"
输出类似:
meta: deep-read-summarize
parsers: book, paper, video, web
4. 真实运行(需要 DSH)
优先把下面的 JSON 直接传给 deep_read_summarize 工具。旧宿主使用技能提供的 meta + script,通过 workflow 工具执行:
{ "input": "https://arxiv.org/abs/2307.09042", "type": "paper", "options": { "maxChunks": 4, "fastMode": true } }
工作流会返回结构化结果:{ ok, kind, title, filePath, qualityPassed, note },note 即最终 Markdown 笔记。
⚠️ 笔记由主代理落盘:DSH 的 workflow 契约规定脚本只能协调子代理(沙箱内没有文件系统),所以脚本只返回
note正文与建议路径filePath,不会自己写文件。插件自带的 SKILL.md 已明确要求模型在拿到结果后用write工具写入filePath——自己拼 workflow 调用时也要记得这一步,否则笔记只存在于返回值里。
用法
deep_read_summarize 工具只需要以下参数;旧宿主将其作为 workflow 的 args,并使用技能中的 meta + script:
{
  "input": "https://arxiv.org/abs/2307.09042",  // 链接或文件路径
  "type": "auto",   // auto | book | paper | video | web
  "options": {
    "minWords": 2500,
    "fastMode": false,        // true 时跳过 5-7 节,速度快一些
    "maxChunks": 4,           // 分块上限,1-12(默认调低,控制子代理数与耗时)
    "transcribe": true,       // 视频:无字幕时自动本地转写(faster-whisper);false 则跳过转写,见「视频」节
    "whisperModel": "small",  // 视频转写模型档位:small | base | medium
    "language": "zh",         // 视频转写语言:纯英文视频可设 "en"
    "device": "cpu",          // 转写设备:cpu(默认)| auto | cuda;auto/cuda 需自备 CUDA 运行库,失败自动回退 cpu
    "maxRetries": 0,          // 质量校验重试次数(默认 0 = 不重试,重试会明显变慢)
    "frontmatter": "obsidian", // frontmatter 键集:obsidian(默认,配 Dataview)| generic(换掉 Hugo 保留键)| minimal
    "requireCitations": true, // 关键结论是否必须标注出处
    "includeTimestamps": false,
    "outputDir": "./output",    // 笔记输出目录(可指向 Obsidian 仓库或静态站点内容目录)
    "tempDir": "./.tmp"        // 临时文件目录
  }
}
示例:
| 类型 | input |
|---|---|
| 论文 | https://arxiv.org/abs/2307.09042 |
| 书籍 | 本地路径,如 ~/books/xxx.pdf |
| 视频 | https://youtube.com/watch?v=xxx |
| 网页 | https://example.com/article |
笔记写到 options.outputDir 指定的目录(默认 ./output,可指向你的 Obsidian 仓库或静态站点内容目录),文件名取自内容标题。
frontmatter 三档(options.frontmatter)
默认 obsidian,键集与历史版本一致,标量和列表值使用安全引号。之所以要分档:type、aliases、url 在 Hugo 里是保留键,语义和 Obsidian 完全不同——直接丢进 Hugo 会改变渲染行为,而不是多几个无害字段。
| 键 | obsidian(默认) |
generic |
minimal |
|---|---|---|---|
title |
✓ | ✓ | ✓ |
aliases |
✓ | — | — |
author / year |
✓ | ✓ | — |
type |
✓ | — | — |
docType |
— | ✓ | — |
url |
✓ | — | — |
sourceUrl |
— | ✓ | ✓ |
tags |
✓ | ✓ | ✓ |
created |
✓ | — | — |
date |
— | ✓ | ✓ |
status |
✓ | ✓ | — |
为什么 generic 要换键:
type在 Hugo 里决定用哪套 layout(type: video会让它去找layouts/video/)aliases在 Hugo 里是一组会重定向到本页的旧 URLurl在 Hugo 里会覆盖页面自身的路径——来源链接会变成文章的永久链接date才是 Hugo/Jekyll 都认的时间键;created只是自定义字段
非法值直接 FATAL 终止(与 type 的失败纪律一致,不静默降级)。
视频:完整逐字稿(字幕优先,无字幕自动转写)
视频取文本是统一流水线(已去掉「三档」):目标 = 拿到完整逐字稿再精读。
⚠️ 为保证精读质量,处理时间可能略长(刻意取舍,不是卡死):无字幕视频会先做一次转写(CPU 上约为视频时长的 0.5–2×)再精读,所以这类视频整体会明显比有字幕视频慢;换来的是完整逐字稿 + 真正的精读。有字幕视频仍是秒级。请勿把转写的较慢误判为卡死。
- 有平台字幕(B站官方 API 的 AI 字幕 / YouTube CC)→ 直接用字幕(=全文,最快、零依赖)。
- 无公开字幕 → 用插件自带转写
scripts/transcribe.js(faster-whisper small / int8 / VAD / 中文)得到全文。 - 都不行 → 降级:提示手动提供转写文本,或退回
desc作背景;绝不阻塞。
options.transcribe:默认 true(无字幕自动转写);设为 false 则跳过转写(只用字幕/desc 或降级)。
转写工具链:脚本用 uv 创建 Python 3.12 环境,从清华镜像安装 faster-whisper==1.2.1,通过 HF_ENDPOINT=https://hf-mirror.com 下载并缓存模型。健康的缓存环境直接运行,不要求 uv 仍在 PATH,也不再启动单独的 Python 导入探测。实际解释器和依赖版本记录在缓存目录的 runtime.json;Python 补丁版本、uv 和传递依赖未全部锁定,不能据此声称环境逐字一致。PyAV 可直接解码音频,无需单独 ffmpeg。三平台使用同一条命令 node scripts/transcribe.js --audio <音频> --out <txt>,默认 CPU;options.device: "auto" 可尝试自备的 CUDA,失败回退 CPU。缓存目录:Windows %LOCALAPPDATA%\deep-read-summarize、macOS ~/Library/Caches/deep-read-summarize、Linux $XDG_CACHE_HOME/deep-read-summarize(未设置时用 ~/.cache)。创建 Python 环境默认先用镜像,失败再直连 GitHub;DRS_UV_PYTHON_MIRROR 可覆盖镜像,空字符串表示直连。
⚠️ 首次转写会先下载模型(small 约 484MB,走 hf-mirror,非 GitHub),可能需要几分钟,请耐心等待;本机只下这一次,之后所有视频转写用缓存、秒开。只有「无字幕」视频才会触发转写(有字幕的视频直接用字幕,不触发、不下载)。
质量/速度:small + int8 量化 + VAD 静音过滤,中文质量可用且 CPU 友好。有字幕的视频不转写(快);无字幕视频转写,CPU 上约为视频时长的 0.5–2×。
失败处理:安装/下载失败则明确报错并降级(提示手动提供转写文本),不静默、不长期阻塞。此时可用 options.transcribe: false 跳过转写。
怎么知道本次用了什么来源:来源信息不写进笔记(保证笔记干净),透出在:① 运行日志的 [source] <值> -> <标签> 行;② 返回结果里的 textSource 字段(subtitle / transcription / desc / manual)。
差异与影响因素(时长与内容为何可能不同)
输出时长与内容会因「模型」和「输入」不同而有明显差异,属正常现象,请知悉:
模型
- ASR 模型档位:
small(默认,中文可用)→base(更快、质量略降)→medium(更好、更慢)。可用options.whisperModel调整;下载量与速度随模型变大而增长。 - 语言/口音:中/英/混合语言、方言、口音、重音 → 转写准确度与耗时不同;纯英文视频可设
language: "en"。 - 精读 LLM:用宿主 DSH 的模型,不同上下文/推理模型 → 输出质量、篇幅、速度不同。
- 非确定性:LLM 与 ASR 均带随机性,同一输入重复跑可能得到略有差异的结果(内容/篇幅)。
输入
- 视频:
- 有无公开字幕是最大差异点——有公开字幕 = 秒级;只有登录态 AI 字幕/无字幕 = 触发转写,明显变慢。
- 时长:越长转写越久(CPU 约 0.5–2× 视频时长)。
- 音质/噪杂/低音量/纯 BGM/无人声:转写易错或结果空,此时请手动提供转写文本。
- 论文/书籍/网页:
- 格式:PDF/EPUB/MOBI/HTML/arXiv;扫描版 OCR、坏 PDF、公式/图表密集 → 提取质量与耗时不同。
- 术语密度/篇幅 → 分块数与精读深度不同。
- 分块结构:不同类型分块方式不同(章节/主题/段落),影响输出结构与覆盖。
硬件
- GPU vs CPU:GPU 转写可比 CPU 快一个数量级(
device='auto'自动选)。CPU 上无字幕视频约 0.5–2× 时长。
其他
- 首次 vs 复用:首次要下模型(约 484MB),之后缓存复用。
- Token/成本:分块数/篇幅/引证决定 token 消耗;
fastMode/maxChunks可省。 - 引用/编造:转写或 OCR 的错词可能被当作「原文」引用,关键引用请复核。
- 边界:纯 BGM、失真音频 → 转写空/差;无字幕且转写不可用 → 降级提示人工提供转写文本。
失败怎么处理
分两类:
- 配置错误(缺 input、type 非法、options 格式错):直接抛异常终止,不产出半成品。
- 内容问题(抓取失败、某块精读失败):返回
{ ok: false, stage, fatal: false },由调用方决定。某一块失败时跳过它、在成稿里标注缺口,不整体中断。
保持质量的提速
- 支持的新宿主优先使用
deep_read_summarize,模型只提交参数,省去复制整份工作流脚本。旧宿主自动保留原入口。 - 精读仍完整覆盖已知原文,最多三个任务并发;空闲槽位立即领取下一块。按行数均衡工作量,避免一个超大块拖住整批。
- QC 继续独立读取原文;不再在每轮上下文中重复塞入全部 Map 笔记。缺总行数、精读失败或只有视频简介等问题不能靠改写笔记解决,不再浪费全文修订轮次。
- 视频
textSource: "desc"明确为降级来源,不能取得完整精读的质量通过状态。B站多 P 链接按p选择对应 CID、分 P 标题和时长。 - 返回
timings提供各阶段毫秒耗时,用同一资料、模型、篇幅和质量门槛比较;调度测试不能当成真实 LLM 加速比例。
本次未改小模型档位、减少字数门槛或抽样跳过原文。常驻 ASR 模型、逐字稿缓存和分层 QC 仍需单独做质量与性能基准。
成本
Token 用量取决于原文长度、分块数和成稿篇幅。原文核验会再次读取资料,每轮修订还会增加一次修订和一次核验调用。fastMode 减少输出章节;调低 maxChunks 限制代理数,同时保留全文覆盖。
使用 lib/cache 的程序化调用方请注意:URL 尾斜杠、空 query 与 fragment 可能选择不同资料,现在会保留;新版指纹自动与旧版缓存隔离,升级后可能需要重新处理一次。该工具不负责证明远程内容未更新,复用前仍须由调用方确认来源与配置。
安全与版权
- 抓取视频/网页会发起外部请求,由子代理在 DSH 的沙箱和审批策略下执行;不要让模型无人值守地跑任意脚本。
- 子代理写文件需要相应权限;如果权限不够,workflow 会把内容返回,由主代理负责落盘。
- 本地转写:视频转写(faster-whisper)在本机运行,音频/字幕不出本地;抓取视频元数据/字幕/音频时才会向对应平台发起网络请求。
- 这个仓库只有流程本身:workflow 定义、解析器代码、提示词模板、schema。不含任何受版权保护内容的提取结果。 测试用的 fixture 是自写的公共领域寓言。用本工作流处理有版权的材料时,产出物的使用责任在你。
开发
npm install
npm run lint       # node --check 全部 JS
npm test           # fixture 测试(35 项,全部离线)
npm run validate   # 发布前验证(含安全检查)
npm publish 会自动先跑 prepublishOnly(测试 + lint + 安全检查),任何一项失败都不会发布。
改动说明见 CHANGELOG.md,贡献规范见 CONTRIBUTING.md。
兼容性
已验证的宿主:DSH 0.2.0-rc.2(Node 24)。本仓库的依赖面只有两处:
| 依赖面 | 现行契约 | 本仓库的用法 |
|---|---|---|
| workflow 脚本钩子 | agent() / pipeline() / parallel() / phase() / log() / args |
只用了 agent/parallel/phase/log/args;agent() 选项只用 label/phase/schema(引擎只接受 label/phase/schema/provider/model,其它选项会被判为 fatal) |
| JSON Schema 子集 | type / properties / required / additionalProperties / items / enum / const / oneOf + 注解键 |
两个 agent() schema 已用宿主真实的 assertObjectJsonSchema 实测通过 |
两点容易踩的契约细节:
- 脚本沙箱没有文件系统/网络/定时器/require——只能协调子代理;笔记落盘由主代理完成(见上文 ⚠️)。
- 违反上述子集不是降级而是终止:引擎抛
UNSUPPORTED_SCHEMA,整条 workflow 直接失败。仓库的npm test里有对应回归(含反向断言,确保校验器不是空放行)。
升级 DSH 后先跑 npm test + npm run test:node;坏了对照 CHANGELOG.md 排查。
License
MIT,见 LICENSE。