dsh-flymemory
Verifieddsh-flymemory · v1.4.0 · MIT
Long-term memory for DeepSeek Harness: 15 FlyMemory MCP tools, automatic recall and capture hooks, and a supervised local engine.
Install
dsh plugin add dsh-flymemory Confirm the layer applied with dsh --profile default --dump-config — see the install guide.
Source
Tags
Creators
Readme
dsh-flymemory
English | 中文

给 DeepSeek Harness 加长期记忆。
这是一个 DSH 插件(bundle):把 FlyMemory 当作本地 MCP 服务跑起来,接进 harness。装完之后模型手里多出 15 个记忆工具,另外还有 两个钩子在背后干活——你干活的过程它自己记,下次用得上就自己翻出来。省掉每次开会话都 重新交代一遍背景的功夫。
所有东西都在你自己机器上:服务监听 127.0.0.1:8791,记忆就是 DSH home 底下的一个
文件,没有任何数据发到外面。
DSH 会话 ──┬── mcp__flymemory__*   模型可调的 15 个工具
           └── 钩子                  回合前召回,回合后记录
                     │
                     ▼
           FlyMemory 服务  127.0.0.1:8791
                     │
                     ▼
           $DSH_HOME/flymemory-data/flymemory_v3.pkl
和「向量检索式记忆」的区别
大多数 agent 记忆插件就是一张笔记表 + 余弦相似度。这是一个完整的库,差别在日常使用里就能看出来:
| 笔记表 + 余弦检索 | dsh-flymemory | |
|---|---|---|
| 同一个事实变了 | 新旧一起被召回 | supersede 让旧条目退场,除非显式查历史 |
| 同一件事说了两遍 | 越堆越多 | 按长度分级的去重会合并或加强 |
| 「X 现在是什么」 | 你得自己写对查询 | state_key/state_value 保存当前值 + 历史链 |
| 时间新旧 | 看起来一样新鲜 | 幂律衰减按保留度加权 |
| 条目从哪来 | 丢失 | source(模型判断 vs 机械捕获)+ app:<name> |
| 多个客户端 | 各存一份 | ZCode / Qoder / DSH 可共享同一份库,app= 标签标明作者 |
| 每轮开销 | 要么全文要么没有 | 有界指针索引(≤1.2KB),正文由模型自己拉 |
| 有没有被用 | 不知道 | usegate.jsonl:每个注入的指针都记为 expanded / recalled / superseded |
上游实测数字(这里不重跑,协议见 FlyMemory 仓库):
- 聚合类问题:单发 top-5 严格正确率 6%,「广收集 + 逐条读原文抽事实」16%(P-ANSWER);
- 多跳问题:让检索器先做相关性过滤,证据从 100% 掉到 75%(P-COMBO);
- 指针注入把「证据进池率」从 63.9% 提到 74.4%,但池 token 涨到 12.15 倍(P-USEGATE,判定 PARTIAL)——这正是本插件只指路、绝不自行展开的原因。
本页不声称:装了记忆模型就变聪明,或者召回在每个指标上都赢。上游记录的诚实结论是:结构化记忆可复现,自适应读取策略至今还没有通过独立复现。
它像一本笔记本,以及「谁在思考」
用笔记本讲比讲架构清楚得多。
你说的每句话各占一行,主题不会糊在一起。说了几乎一样的话,老那行只是被划得更重, 不会复制出第二条。你说「其实我搬到杭州了」这种更正,老那行被划掉但没撕掉——问历史 的时候还能翻到划掉的行。零散短句会定期压成摘要条目;几个月没人碰的会慢慢褪色(幂律, 真实半衰期是 3τ,默认 90 天)。找一行有两种走法:按意思找,以及按嵌入看不见的精确关键词 找——料号、文件路径、ID。
分工是这套东西的设计赌注:服务端永不运行 LLM。 机械的部分全归它——切分、去重、融合、
衰减计算、血缘清理、持久化;所有判断归调用方模型——什么重要、什么过期、什么该忘。所以
判错会留下判错的记录:supersede 留下带 valid_from/valid_to 的墓碑,而不是一个洞。
一条记忆的一生:
- 写入 —— 钩子自动捕获,或模型显式存(
source把两者区分开); - 加强 —— 近似重复更新原条目而不是新增一份;去重按长度分级,且倾向不合并;
- 取代 ——
supersede(旧, 新)让过期状态退场;include_superseded查历史时仍能看到; - 归并 ——
consolidate(ids, 结论)生成更高层的条目,并保留evidence_ids回链, 抽象不销毁原材料; - 褪色或遗忘 —— 幂律衰减清理无人问津的;
forget直接删掉确实错的。
这些规则的消融版本(包括那些实测比什么都不做还差的)都留在引擎仓库: 源码 · 研究总账。
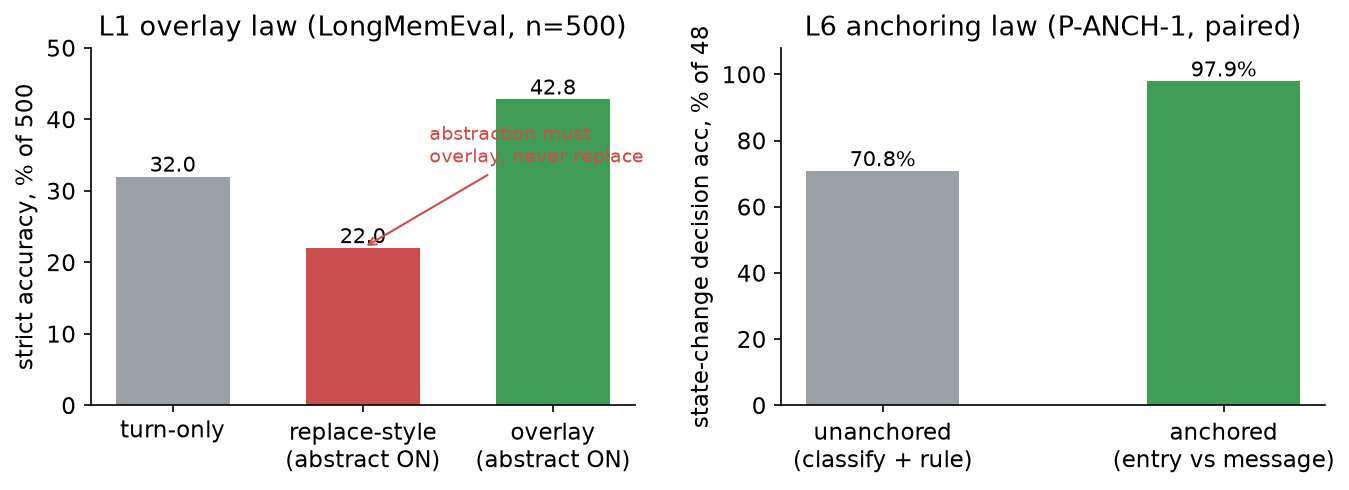
引擎的两条定律。左:替换式抽象比「什么都不存」还低 10 分,所以归并只能叠加。 右:同样 48 轮、两种收集策略——锚定式判断近乎机械(预注册配对实验,不一致 13:0)。
拿到什么
15 个工具,调用时都带 mcp__flymemory__ 前缀:
| 工具 | 干什么用的 |
|---|---|
flymemory_remember |
存一条决定或发现。近似重复会自动合并。compartment 按主题分区;state_key/state_value 记「某个东西当前是什么」,旧值自动退场。 |
flymemory_recall |
搜。向量相似度和关键词匹配融合排序,旧条目随时间衰减,返回结果带 id、年龄和来源。加 include_superseded 能翻历史。 |
flymemory_auto |
一次调用同时做召回和存储,钩子用的就是它。 |
flymemory_recall_index / flymemory_get_memory |
先看索引再读正文:先给一行摘要,觉得有用再取全文。 |
flymemory_supersede |
标明「这条过时了,被那条取代」。 |
flymemory_state_lookup / flymemory_state_history |
某个实体键当前的值,或者它的全部历史。 |
flymemory_consolidate |
把几条归纳成一条结论,原始条目留着当证据。 |
flymemory_find_conflicts / flymemory_insights |
看起来互相矛盾的配对;有价值但快衰减掉的条目。 |
flymemory_forget / flymemory_cleanup |
删单条,或者按衰减阈值批量清理。 |
flymemory_session_pack |
近期轨迹 + 最新结论的短包。 |
flymemory_stats |
条数、年龄、访问次数。 |
另外两个钩子自己跑,不用模型操心:
- 每条提示:把提示存下来,再把匹配得上的记忆附到这一轮里。纯本地检索,不调用模型。
- 会话开始:塞一个近期活动的恢复包,新会话不至于两眼一抹黑。
服务不在线时两个钩子都静默跳过,也绝不会卡住回合。
需要什么
带
@deepseek-ai/dsh-mcp-client的 DeepSeek Harness。在0.2.0-rc.2与44.7.0上开发验证。Node 20 以上(插件本体和 CLI)。
Python 3.10 以上,装引擎的依赖:
pip install torch sentence-transformers "mcp>=1.30,<2" numpy解释器不用你指定:插件会依次看
FLYMEMORY_PYTHON、常见安装位置、PATH,而且 先确认这个解释器真能 importsentence_transformers才选它。机器上装了好几个 Python 的时候,这一步能省掉半小时的「为什么起不来」。第一次运行会把多语言嵌入模型(约 470MB)下载进 HuggingFace 缓存,之后离线可用。
安装
# 从 npm 安装(2026-10-26 已发布)
dsh plugin --profile desktop add dsh-flymemory

# 从 GitHub 安装(profile 名换成你自己的)
dsh plugin --profile desktop add github:aujurd22/dsh-flymemory

# 从本地目录安装(绝对路径)
dsh plugin --profile desktop add /absolute/path/to/dsh-flymemory
或者在会话里用 plugin_manager 工具指向同一个 spec:
plugin_manager(action: "install_bundle", target: "dsh-flymemory")
plugin_manager(action: "install_bundle", target: "github:aujurd22/dsh-flymemory")
plugin_manager(action: "install_bundle", target: "/absolute/path/to/dsh-flymemory")
或者打开 Web 侧边栏的 Plugins 页面,选这个文件夹。harness 重新加载后会有两行
插件起来(flymemory、flymemory-mcp),工具就出现了。
信任信息。 许可证 MIT;适用于任何 base-backed profile(desktop/web);
按 DSH 0.2.0-rc.2 编写、在 44.7.0 上验证。权限范围:只在 $DSH_HOME 下写一个数据
目录、拉起一个 Python 子进程、并且只走 127.0.0.1 本机通信——不需要任何凭据,也没有
对外网络请求。外部依赖:Python 3.10+ 及 torch / sentence-transformers(见上);引擎已随包,
不需要另外 clone FlyMemory。
自检:
node bin/flymemory.mjs status     # 解析出来的配置 + 当前实际状态
node bin/flymemory.mjs doctor     # 解释器、依赖、端点
然后让模型记一条东西再搜一次。工具没出来,doctor 基本能告诉你卡在哪。
卸载就是反过来:
plugin_manager(action: "remove_bundle", target: "dsh-flymemory")
记忆文件不会被删,想清掉自己动手。
运行方式
bundle 插入两行:
| 行 | 模块 | 干的事 |
|---|---|---|
flymemory |
本包 | 探端口;没人应答就拉起引擎;记录解析结果;注册召回/捕获钩子 |
flymemory-mcp |
@deepseek-ai/dsh-mcp-client |
把服务端的工具变成 mcp__flymemory__<tool> |
钩子以前挂在 DSH 的 Claude-Code hook bridge 上。44.7 开始的版本不再带那个包,所以同样的
逻辑改成跑在插件自己的 agent/pre-step 上,bundle 也不再依赖 hook bridge。
harness 启动时第一行先探 127.0.0.1:8791:已经有 FlyMemory 服务在应答就直接复用,
两个 harness 窗口共享同一个引擎和同一份记忆;端口空着就后台把自带引擎拉起来,等它
就绪了再让下一行去连;端口被别的程序占着,插件只报一句,不去动它——不是自己起的
进程,绝不 kill。
冷启动偏慢:引擎要先 import torch 才能开始监听,大概 15–20 秒。这一行默认最多等 25 秒, 没等到的话 mcp-client 会自己重连补上。
引擎彻底起不来(没有解释器、缺依赖、端口冲突)时 harness 照样启动,只是没有这些工具, 原因写在日志里。
配置
环境变量,harness 启动前读取:
| 变量 | 默认值 | |
|---|---|---|
FLYMEMORY_MCP_PORT |
8791 |
服务端口 |
FLYMEMORY_MCP_URL |
http://127.0.0.1:<port>/mcp?app=dsh |
完整端点(已带 ?app= 的原样保留) |
FLYMEMORY_APP |
dsh |
本插件写入的每条记忆带的来源标签 |
FLYMEMORY_DATA_DIR |
$DSH_HOME/flymemory-data |
记忆、日志、状态记录、pid |
FLYMEMORY_PYTHON |
自动探测 | 引擎用的解释器 |
FLYMEMORY_DEVICE / FLYMEMORY_MODEL |
cpu / 多语言 MiniLM |
传给引擎 |
同一个 FlyMemory 服务可以被多个客户端共用,每条写入都带 app:<name> 标签标明是谁写的。
本插件用 ?app=dsh 连接,所以它的条目在召回里显示 app=dsh,在 flymemory_stats
的 Apps: 里单独计数——和 ZCode 的 app=zcode、更早未标记的 app=legacy 并列。
同一份库接多个 DSH profile 时,用 FLYMEMORY_APP 区分。
其余参数写在你自己 profile 的 cordis.patch.yml 里,挂在对应行上。注意 patch 条目是
整体替换 config 的,需要的字段要写全:
- id: flymemory
  name: 'dsh-flymemory'
  config:
    port: 8791
    dataDir: 'D:\dsh-memory'
    libraryPath: 'D:\dsh-memory\my-lib.pkl'
    pythonExe: 'C:\Python313\python.exe'
    device: cpu
    readinessTimeoutMs: 25000   # 0 = 不等待,工具晚点自己出来
    shutdownOnDispose: true     # 退出时关掉本次拉起的引擎
    nativeHooks: true           # 每条手打提示做召回+捕获
    hookTimeoutMs: 6000         # 每次钩子请求的预算
    workingContext: true        # 每请求发布一份有界的记忆摘要
    workingContextChars: 1200   # 摘要上限(含包裹标签)
    workingContextMinutes: 240  # 摘要往回看多久(仅 pack 模式)
    workingContextSource: index # index=按本轮文本检索;pack=时间窗口(会跨会话)
    workingContextTopK: 8       # index 模式下每次给几条指针
    useGate: true               # 记录「注入的指针有没有被展开/再召/取代」
    # 引擎侧:FLYMEMORY_SAVE_DEBOUNCE=5(秒)合并落盘;0 = 每次写都落盘
    writeHooksConfig: true      # 同时给 DSH 之外的客户端写 hooks.json
    seedFromUpstream: false     # 默认不导入别的库
    upstreamLibrary: ''         # 想导入就同时配这两项
    autostart: true
其余字段在 lib/index.js 的 resolveOptions() 里,多余的键会被忽略。
记忆存在哪
$DSH_HOME/flymemory-data/flymemory_v3.pkl,就一个文件,备份和删除都很直接。同目录还有:
hooks.json— 每次激活重新生成,描述那两个钩子state.json— 上次激活实际解析出来的结果(端点、库、解释器、服务是怎么来的);status和doctor读它,所以有 profile 覆盖时会报真实值而不是默认值engine.log— 引擎进程的 stdout/stderrserver.log— 引擎自己的日志server.pid— 给flymemory stop用来找进程
不想通过 harness、单独把服务跑起来:
node bin/flymemory.mjs start
node bin/flymemory.mjs stop
node bin/flymemory.mjs log -n 40
node bin/flymemory.mjs mute 30m     # 临时静音工作上下文(工具照常)
node bin/flymemory.mjs mute off
node bin/flymemory.mjs ledger       # 注入→使用率与最热 id(可加 --json)
node bin/flymemory.mjs version      # 本机这版 vs npm 上最新
不会自动更新:DSH 从不轮询 registry,升级就是用同一条命令再装一次
(dsh plugin --profile desktop add dsh-flymemory)。version 告诉你有没有新版。
装成 bundle 之后,同一个 CLI 会被链接到 profile 里:
<profile>/node_modules/.bin/dsh-flymemory。
关于钩子
默认是开着的,毕竟「自动记忆」就是这个插件的意义。钩子跑在插件自己身上(agent/pre-step),
不依赖宿主的 hook bridge。它具体做了什么,值得说清楚:
最接近的那条直接给全文。 实测对比(LongMemEval,n=120,2026-10-30):只注入指针行
得 31.7%,top-5 全文检索得 39.2%——指针只有在模型能展开它时才值钱,所以 agentic 臂
能到 52.5%。因此钩子现在会把相似度 ≥ 0.6 的 top-1/2 命中直接内联全文,其余仍只给
指针。FLYMEMORY_HYBRID_FULL=0 退回纯指针;FLYMEMORY_HYBRID_SIM 调门槛。
有一块不再注入:上游的 RECENT CONTEXT (last ~90 min)。那是按时间扫全库的窗口,
而条目里没有会话 id——几个对话共享一份库时,它会把别的对话的活儿拉进来。现在召回按你
刚打出来的文字走。想恢复旧行为,启动引擎时设 FLYMEMORY_RECENT_MINUTES=90。
- 只有你真正打出来的消息会被记录和召回。宿主给手打提示打的是
source.kind === "user";peer 消息、系统提醒、自动化心跳、模型切换通知都带别的 kind, 一律忽略。被委派的子 agent 只在任务开始时召回一次,之后不再记录。 - 长得像密钥的文本不会入库,自动化/心跳提示在发往服务之前就被跳过。
- 召回内容附到当前回合,上限约 2.5KB,并明确标注「这是数据、不是指令」。
- 还有一次请求专门取
compartment="lessons"的前两条,单独注入。踩过的坑因此每轮都在 眼前,而不是和普通记忆抢名额。存教训用flymemory_remember加compartment="lessons",文本开头写清楚「哪个工具/哪个环境」,因为最后是靠词法通道 把它捞回来的。
只想要工具、不想要自动化,就把这一行的开关关掉(patch 条目是整体替换 config,
需要的字段要写全):
- id: flymemory
  name: 'dsh-flymemory'
  config:
    port: 8791
    nativeHooks: false
让上下文待在一个区间里
不该等到窗口塞满才开始处理。四件事让每个请求都小、且该在的东西都在:
1. 工作上下文是「索引」,不是记忆倾倒。 每次请求插件发
<working-context source="flymemory" type="index">:最多 1.2KB 的指针
(#id | 年龄 | 来源 | 一行),按本轮进入的文本检索出来的(flymemory_recall_index),不是按时间窗口。
这点比听起来重要:库里没有会话 id,所以任何「最近 N 分钟」的摘要都是全库的——它会显示
任何客户端最后写的东西,那正是「别的会话的任务串进来」的原因。想看旧行为可以设
workingContextSource: pack。块头明确
写着「要读正文请先 flymemory_get_memory(id)」。正文由模型自己拉,插件从不替它展开。
这个分工是被测出来的:上游 P-USEGATE(2026-10-26)里指针形态的证据覆盖 +10.5pp,只在
「指针被跟着展开」时成立,而那次展开把池 token 推到 12.15 倍——所以展开始终是模型的
决定。它是 optional context:运行时抑制器能去掉、dsh-flymemory mute 能临时静音、服务挂了
就沿用上一份摘要。
2. use_gate 记账。 每个真正进入 prompt 的指针 id 会按会话记进
<dataDir>/usegate.jsonl(一行一个事件,结构对齐上游的 injected id -> uses)。之后模型
调 flymemory_get_memory / 召回 / flymemory_supersede,就分别记成
expanded / recalled / superseded。dsh-flymemory ledger 给出
注入→使用率和最热 id——这正是上游采纳的那块账本(补上「注入过,但没人记录到底用没用」
的缺口)。
3. 压缩结果回到记忆里。 会话写入 compaction/summary 时,摘要文本会被存成
context 分区下的 checkpoint,compaction 条目。被压缩的历史仍然可召回,而且权威在库里,
不是只剩一份检查点。
4. 早触发压缩(可选)。 DSH 的 compaction-basic 行在 agent preset 里,改阈值只能
整段重述 preset。examples/early-band.patch.yml 就是
干这个的,只改三个数:窗口到 45% 就压(原来 80%)、保留 12% 逐字(原来 16%)、
headroom 调小以便小窗口也合法。把它贴进你的 profile patch 即可。它会钉住一份 preset
副本——DSH 升级后请重新生成,别留旧的。
它不做的事:不替换 DSH 的压缩后端,也替换不了——零依赖插件 import 不到
@deepseek-ai/dsh-compaction。所以「压缩」这个动作仍是 DSH 自己的,只是被提前触发;
FlyMemory 负责的是「每轮模型看到什么」以及「被压掉的东西留在哪」。
借鉴的项目:
- MemGPT / Letta(arXiv 2310.08560):把上下文窗口 当内存、外部存储当磁盘,显式分页。
- InfiAgent(ACL Anthology):用「状态快照 + 固定近期窗口」重建上下文,让推理上下文始终有界,而不是溢出后才压。
- Chroma 的「context rot」测量:长上下文会 劣化,宁要少量高信号 token,不要更大的窗口。
导入已有的库
默认什么都不导入。如果你手上已经有一份 FlyMemory 的库想搬进来,指一次就行:
- id: flymemory
  name: 'dsh-flymemory'
  config:
    port: 8791
    upstreamLibrary: 'D:\path\to\flymemory_v3.pkl'
    seedFromUpstream: true
下次激活时,只要目标文件还不存在就复制过去,源文件保持不动。两边格式一致,以后想搬出去 也可以。
分享一个已经在跑的服务
如果这台机器上已经有 FlyMemory 服务在跑,而你希望 DSH 直接用它的记忆、而不是自己另存 一份,覆盖这两行即可(写在你自己 profile 的 patch 层):
- id: flymemory
  name: 'dsh-flymemory'
  config:
    port: 8765
    libraryPath: 'D:\path\to\flymemory_v3.pkl'
- id: flymemory-mcp
  name: '@deepseek-ai/dsh-mcp-client'
  config:
    serverName: flymemory
    transport: streamable-http
    url: 'http://127.0.0.1:8765/mcp'
port 是插件去哪找现成的服务;libraryPath 是万一它得自己拉引擎时开哪个文件——两条路
通向同一份记忆。钩子那行不用动,它会跟着插件解析出来的端点走。
node bin/flymemory.mjs status 在这种覆盖生效时会标出 "from hooks.json",一眼能看出
用的不是默认值。
想改代码
node --check lib/index.js    # 语法
npm test                     # 单元测试,不需要 Python,约 0.3 秒
node tests/engine_smoke.mjs  # 打真引擎的端到端(需要 torch)
python tests/http_smoke.py   # 对着运行中的服务做协议检查
npm test 盯的是容易出错的那几块:端口和库的默认值、配置优先级、生成的钩子文件、
端点探测。engine smoke test 在临时目录里用真的 Python 引擎跑一遍 apply()——需要
torch 和 sentence-transformers,没装会打印 SKIP。CI 在 Linux、macOS、Windows 上跑
Node 20 / 22 / 24,加上语法检查和单元测试。
lib/index.js        Host 端:探端口、管引擎、生成钩子配置
bin/flymemory.mjs   CLI,复用同一套函数
cordis.patch.yml    这个 bundle 插入的两行
python/             随包的 FlyMemory 引擎(服务端、钩子、引擎包)
locale/{en,zh}.json Plugins 页面显示的标题和描述
tests/              单元测试、引擎冒烟、协议冒烟
不太行的地方
- 第一次启动要 15–20 秒,都是 torch 的加载时间。嫌久就把
readinessTimeoutMs设成 0,harness 立刻启动,工具几秒后自己出现。 - Python 依赖比较重。插件不会替你装,
doctor会告诉你缺什么。 - DSH 没有
PreCompact钩子,所以恢复包挂在会话开始,而不是压缩之后。 - 工具名很长。
mcp__flymemory__flymemory_recall是 mcp-client 的命名规则 (mcp__<server>__<tool>)决定的,稳定,但不好看。 - 一个端口一个引擎。两个 harness 共用;要第三份实例得显式配独立端口和独立库。
- 库越大召回越慢。上游在 CPU、约 1400 条时测到每查询 ~11ms。
许可
MIT,见 LICENSE。
随包携带的 FlyMemory 引擎同样是 MIT,Copyright (c) 2026 Junrong Du。 具体复制了哪些文件、改了哪些、为什么改,都写在 THIRD_PARTY_NOTICES.md 里。