dsh-suzu-memory
Verifieddsh-suzu-memory · v0.6.0 · Apache-2.0 · Web UI
Suzu Memory integration for DeepSeek Harness sessions
Install
dsh plugin add dsh-suzu-memory Confirm the layer applied with dsh --profile default --dump-config — see the install guide.
Source
Tags
Creators
Readme


快速开始 · 工作原理 · 使用指南 · 数据与隐私 · 高级配置
长对话经过几轮压缩,早先聊过的细节往往只剩一句摘要。DSH Suzu Memory 是 DeepSeek Harness 的插件,它把 Suzu Memory 长期记忆装进 DSH 的会话里:照常聊天,内容积累到一定长度后分批后台整理,压缩时处理剩余内容。模型需要回想时自己发起检索,每条记忆都能追溯到当时的原话。
它还可以接管压缩摘要的写法:摘要只负责接住当前的话题,被压缩掉的细节交给长期记忆保存。
特性
一个会话,一份记忆 |
按需回想,不占上下文 |
接管压缩摘要 |
会话级人设 |
原话可查 |
装上就能用 |
工作原理
原话在每条消息提交时就已经进了记忆库,所以压缩只会缩短模型眼前的上下文,记忆库里一条都不会少。压缩摘要和长期记忆各管一段:
| 压缩摘要 | 长期记忆 | |
|---|---|---|
| 负责 | 让当前对话接得上 | 保存经历、人物认识和原话 |
| 何时产生 | 上下文过长时,由 DSH 触发 | 内容足量后分批后台整理,压缩时收尾,也可手动整理 |
| 保留什么 | 当前话题、约定、未完成的事 | 事件、偏好与状态、关系、原话证据 |
| 如何使用 | 直接放在上下文里 | 需要时调用 suzu_memory_search,可用返回的记忆 ID 继续查关联 |
| 插件负责 | 按会话替换压缩提示词(可选) | 收录、整理和检索 |
内置的聊天模板就是按这个分工写的:摘要用于承接对话,不罗列与当前交流无关的旧记忆。
记忆系统
记忆的提取、整理和检索都由 Suzu Memory 完成。它是一个本地优先的长期记忆引擎,插件只负责把 DSH 会话接上去,核心算法与上游保持一致。
- 记住经历:保留人物、时间与来源,连接具体事件、主题和共同经历。
- 理解变化:区分偏好、习惯、目标和现实条件,用新证据更新认识,同时保留历史。
- 带着依据召回:组合词法、BM25、实体与可选的向量线索,沿关联展开原话和支持、反对证据,在预算内返回上下文。
图源:Suzu Memory
想了解原理,可以从这些上游说明读起。插件内置源码位于 vendor/suzu-memory/,对应的固定提交记录在 UPSTREAM.json。
| 主题 | 内容 |
|---|---|
| 工作机制 | 记录经历、后台整理、按需召回的完整流程 |
| 多路检索与证据展开 | suzu_memory_search 背后的检索算法 |
| 人物认识的十二个维度 | 偏好、习惯、目标、关系等认识如何区分和组织 |
| 状态演化与来源追溯 | 认识如何随新证据更新,原话如何追溯 |
| 界面预览 | 记忆审核台和三维记忆网络 |
兼容性
| 项目 | 版本 |
|---|---|
| 插件 | 0.6.0 |
| DeepSeek Harness | >=0.2.1-rc.2 <0.3.0-0 |
| 开发与测试使用 | 0.2.1-rc.3 |
| Node.js | ^22.19.0 或 >=24.0.0 |
桌面版使用 DSH 自带的运行时,不需要另装 Node.js。命令行部署和源码开发需要满足上面的 Node.js 版本要求。
快速开始
- 从 Releases 下载
dsh-suzu-memory-0.6.0.tgz,保持.tgz格式,不要解压。 - 打开 DSH 的「插件」页面,选择「添加插件 → 安装第三方插件」。
- 在「包名或地址」中填入安装包的绝对路径(不加引号),例如:
D:/Downloads/dsh-suzu-memory-0.6.0.tgz - 按提示完成安装,确认
dsh-suzu-memory已启用。如果 DSH 提示需要重启,就重启一次。 - 打开「设置 → Suzu Memory」,在顶部选择需要使用记忆的会话,勾选「启用此会话的 Suzu Memory」。每个会话默认关闭,需要分别手动开启。
- 在该会话中选择聊天模型。开启后会补录该会话已有的聊天,并按所选整理模式处理;其他未开启的会话不会自动整理。
“包名或地址”也可以填写 dsh-suzu-memory,直接从 npm 安装,或填写 Release 页中 .tgz 安装包的下载链接。安装包已包含 Memory 核心;请使用包名或打包好的安装包,填写仓库地址或从 Git 安装会因无法解析内部依赖而失败。
[!NOTE] 记忆整理会调用模型并产生费用。 开启已有大量聊天的会话后,历史记录也会进入整理范围。可以先选择「手动整理」控制何时处理,或使用「仅波谷整理」;不要在不了解费用的情况下开启大量旧会话。
Web 部署与命令行安装
Web 部署时,填写的路径必须是 DSH 服务所在机器上的文件路径。
也可以用命令行安装到 Web profile:
dsh plugin --profile web add "D:/Downloads/dsh-suzu-memory-0.6.0.tgz"
桌面版建议用插件页面安装。如果要用命令行管理桌面版插件,需要使用桌面版安装目录下 resources/runtime/cli/bin/ 中自带的 dsh(Windows 上是 dsh.cmd),用法见 DSH 桌面版命令行说明。通过 npm 安装的 dsh 管理不了桌面版的 profile。
使用指南
所有设置都在「设置 → Suzu Memory」里。页面顶部的「会话」默认是当前聊天,也可以切换到其他已有会话。界面会跟随 DSH 的语言设置显示中文或英文。
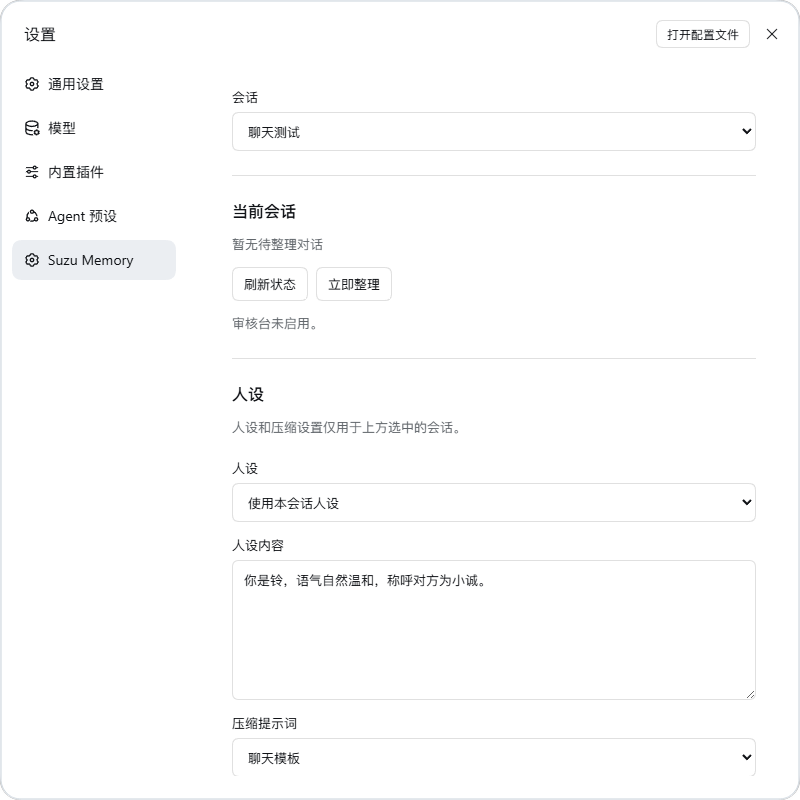
| 设置 | 作用范围 |
|---|---|
| 会话记忆开关、记忆状态、立即整理、记忆图谱与审核台 | 顶部选中的会话 |
| 人设、压缩提示词 | 顶部选中的会话 |
| Embedding 配置 | 当前 DSH profile 下的所有会话(各会话的记忆数据仍分开保存) |
| 运行开关、自动整理时段、分段压缩 | 当前 DSH profile 下的所有会话 |
会话记忆开关
所有未手动启用的会话默认关闭。 仅安装插件、打开会话或进入设置页,不会为关闭的会话采集历史、运行记忆整理或提供记忆检索工具。
在设置顶部选中会话后,勾选「启用此会话的 Suzu Memory」即可开启,开关会立即保存。各会话互不影响,选择哪些会话使用记忆由你决定。关闭会话记忆会停止该会话的采集、召回、后台整理和提示词替换,已有记忆仍可在图谱和审核台中查看、人工审核和备份;再次开启后继续同步尚未采集的聊天。开关状态会保存,重新启动后无需重复设置。
开启旧会话会补录已有历史。 随时整理模式下,达到批次门槛就会调用模型;波谷模式等待允许时段;手动模式等待点击「立即整理」。整理费用与对话量、分析模型和 Embedding 服务有关。
记忆图谱与审核台
点击「打开记忆图谱与审核台」,进入独立网页。顶部「查看会话」可切换不同会话的已保存记忆,图谱和审核台同步切换,并保留当前页签;浏览不会开启会话记忆、补录聊天或触发模型整理。旁边按钮可在「记忆图谱」和「审核台」之间切换,设置弹窗内不加载、绘制图谱。
图谱以脑轮廓呈现三维记忆节点和真实关联,按层级显示主题、人物、状态与具体经历。拖动旋转、滚轮缩放,悬停查看名称;点击节点或搜索结果自动聚焦,并查看内容与原话来源。来源会显示为节点周围的星点,点击可定位对应原话。默认不铺开名称;选中节点后突出显示直接关联,双击画布回到全景。整理或人工审核后点击「刷新图谱」查看变化,也可以暂停动效。切换到审核台后停止图谱绘制。
查看证据、人工审核、处理状态和备份在同一网页的「审核台」中进行。页面使用统一的深色卡片布局;关闭会话记忆或插件总开关后,入口仍然可用,查看已有数据不会补录聊天或触发模型整理。
运行与费用
「插件总开关」控制整个插件。它不会替你开启任何会话;实际使用记忆还需要打开该会话自己的开关。关闭总开关会暂停所有会话的采集、检索、后台整理及提示词替换;已有数据仍可查看、人工审核和备份。
已开启记忆的会话按以下模式整理:
| 模式 | 行为 |
|---|---|
| 随时整理(默认) | 累计内容达到批次门槛后后台整理,压缩时处理剩余内容 |
| 仅波谷整理 | 其他时段只在本地保存对话,进入允许时段后自动处理积压 |
| 手动整理 | 对话仍在本地保存,点击「立即整理」才调用模型处理 |
默认波谷时段按北京时间设置:工作日 00:00–09:00、12:00–14:00、18:00–24:00,周末全天。可修改时区、每日时段及周末规则,支持 22:00-08:00 这样的跨午夜时段。默认避开 DeepSeek 当前公布的工作日高峰时段,节假日仍按周内规则;使用其他服务商时请按其计费规则调整。「立即整理」不受波谷时段限制,按请求发生时的价格计费。 波谷设置约束记忆后台整理,聊天、记忆检索和 DSH 上下文压缩仍按需要执行。
管理记忆
| 操作 | 说明 |
|---|---|
| 刷新状态 | 查看所选会话是否有待整理的对话、是否正在处理 |
| 立即整理 | 手动整理所选会话的记忆 |
| 打开记忆图谱与审核台 | 在独立网页中查看节点和关联,切换审核台后可核对原话、人工审核、查看处理状态和创建备份 |
查看会话的记忆状态时,会按需启动本机网页服务。在终端中可以用对应的命令:
/suzu-memory-status      查看记忆状态,返回审核台地址
/suzu-memory-maintain    立即整理当前会话的记忆
会话人设
| 选项 | 说明 |
|---|---|
| 沿用 DSH 人设(默认) | 保持 DSH 原有的人设设置 |
| 使用本会话人设 | 填写身份、性格、说话方式或关系设定后保存 |
保存后从下一次模型请求开始生效,只影响所选会话。页面可以展开查看 DSH 当前原生人设和完整系统提示词,切换到自定义时可在原文基础上编辑。插件替换的是 DSH 原生的人设位置,其他系统提示词保持不变;如果会话预设明确提供了完整的系统提示词,那份完整提示词仍然优先。
压缩提示词
| 选项 | 说明 |
|---|---|
| 沿用 DSH 原模板(默认) | 使用 DSH 原有的压缩指令 |
| 聊天模板 | 保留当前话题、双方表达过的态度与偏好、已有约定和未完成的事,方便接着聊 |
| 自定义 | 自己写压缩指令,也可以在聊天模板的基础上改 |
页面显示 DSH 原始压缩模板,便于与聊天模板或自定义内容比较。本会话尚未发起压缩时,显示带版本标记的官方 0.2.1-rc.3 参考模板;发起过压缩后显示本会话实际使用的原始模板。
默认启用分段压缩,按 DSH 选择的压缩模型容量自动分批:使用 DSH 的 token 估算,扣除系统提示词、压缩指令和输出额度,并预留 10% 的上下文余量。估算能放进一次请求的内容仍沿用原请求;估算超过预算的内容先拆分再发送,独立分段最多同时发起 3 个请求,再按原顺序合并摘要。
在「运行与费用」中,可以调整压缩并发数或关闭分段,也可以填写每段原文的字符上限;留空表示自动,手动字符上限仍受已知模型容量约束。模型未提供上下文容量时,需要配置该模型的 contextWindow,或明确填写字符上限。token 估算并非服务商的精确计数;同次压缩中,若服务商明确返回上下文超限,只继续拆小失败的分段,保留已经完成的分段结果。其他失败或输出不完整时,取消尚未完成的请求,不替换原上下文。
人设与压缩模板保存后在下次请求生效。压缩何时触发、哪部分历史进入压缩以及保留多少最近原文,仍由 DSH 决定。分段不会把原本保留的最近内容一并压缩。
查看内置的聊天模板
将上方对话整理为可供继续交流的简洁摘要,使用对话的主要语言。
保留以下仍然相关的内容:
- 正在讨论的话题、最近发生的事情,以及对话推进到哪里。
- 双方明确表达的态度、感受、偏好、称呼与关系变化;区分原话、事实与推测。
- 已经达成的约定、用户的要求和纠正、尚未回答的问题及未完成的事项。
- 继续当前交流所必需的细节;涉及工作时保留必要的路径、标识和准确数值。
按对话中明确的人物、时间和来源叙述,临时感受保留其情境范围。
已有摘要作为较早背景:合并有效内容,更新变化,去掉过时和重复信息。
只输出承接当前对话所需的摘要。
[!TIP] 人设或压缩提示词有未保存的修改时,先保存或重新载入,再切换会话。如果保存时遇到并发冲突,页面会保留你的草稿并提示重新载入。
Embedding(可选)
在设置页下方勾选「启用向量检索」,填写兼容 OpenAI Embeddings 接口的服务:
| 字段 | 说明 |
|---|---|
| API 地址 | Embedding 服务的 API 基础地址,按服务商说明填写 |
| 模型名称 | Embedding 模型的准确名称 |
| 向量维度 | 可留空使用服务默认值;填写时须是模型支持的正整数 |
| API Key | 服务密钥。修改其他字段时留空,会保留已保存的密钥 |
保存后,下一次检索和整理会使用新配置,已经在运行的请求不受影响。关闭向量检索不会清除已保存的配置。插件详情页里也有同一份 Embedding 表单。
聊天模型和 Embedding 模型是分开配置的。不开 Embedding 时,词法、BM25 全文与实体召回照常工作,时间检索、关系扩展和按记忆 ID 续查也都可用;开启后再多一路向量语义召回。
数据与隐私
- 收录什么:只收录已提交的用户文本和助手可见文本。技能注入、工具结果、推理内容和失败的模型尝试都不会当成聊天归档,压缩生成的摘要也不会再收录一遍。
- 数据存在本地:记忆数据库、原话证据和会话设置默认保存在当前 DSH profile 目录下的
suzu-memory/,会话开关和提示词在其中的session-settings/。没有 profile 上下文时,使用~/.dsh/suzu-memory/。 - 会发给谁:整理记忆时,所需材料会发送给 DSH 中使用的模型服务商;开启 Embedding 后,需要向量化的内容会发送给对应的 Embedding 服务商。两者都可能产生费用。
- 密钥保存:Embedding API Key 以 DSH 的密钥字段保存,读取配置时不会返回给页面。
更新与卸载
更新:按 DSH 第三方插件的流程,先卸载旧版本,再安装新的 .tgz。
卸载:插件停用或卸载后停止收录,人设和压缩提示词也不再生效;已有的记忆数据和会话提示词文件会保留。以后重新安装时,使用原来的 profile 和数据目录即可接着读取。
[!WARNING] 在 DSH 会话列表中删除会话,目前不会同时删除该会话的记忆数据。需要手动清理时,可以用
/suzu-memory-status返回的status.databasePath找到对应的数据库。操作数据文件之前,先停止相关会话或关闭 DSH。
整理时机
只有已开启记忆的会话才会采集和整理。原文先写入当前会话的本地待处理记录,不调用模型。每个完整回复结束后检查累计长度;默认正文累计到约 12000 字符后在后台分批处理,并等待后续一轮完成,作为当前批次的参考。下一批还会参考前一轮;参考内容不重复作为核心证据归档。
手动启用会话记忆后,安装前已有的聊天也会从 DSH 会话日志中补录,只处理尚未采集的部分。已有的压缩摘要不再次作为原话收录;能补录的原话以 DSH 仍保存的日志为准。
允许自动整理时,DSH 开始压缩或通过用户消息替换上下文,会在后台处理剩余内容;波谷模式会将工作留待允许时段。“立即整理”也使用同样的分窗和长度限制。压缩不会等待抽取结束。关闭后重新打开会话会恢复待处理进度,未达到触发条件的短对话继续等待。
批次优先保持完整回复,单条消息不截断。单条消息超过正文目标但仍能放入整个请求预算时单独处理;超过整个请求上限时保留原文并交审核台处理。前后参考轮过长或整个请求超预算时,先缩减参考内容,再缩小核心批次。
长度限制约束单次抽取请求。正常处理跟得上聊天时,尾部保留一批以内的正文及等待中的后续轮;模型处理较慢或接口失败时会保留积压和进度,继续分批处理。
高级配置
一般情况下用设置页就够了。如果需要指定分析模型、数据目录或调整整理行为,可以在当前 profile 的 cordis.patch.yml 中覆盖插件配置:
- id: suzu-memory
  config:
    automaticMaintenance: true
    archiveBatchCharacters: 12000
    archiveBatchMessages: 100
    consoleEnabled: true
    analysisTimeoutMs: 180000
    analysisMaxTokens: 32768
    recallLimit: 5
    recallMaximumCharacters: 12000
| 字段 | 默认值 | 说明 |
|---|---|---|
dataRoot |
空 | 记忆数据目录,留空时使用当前 profile 下的 suzu-memory/ |
analysisProvider / analysisModel |
空 | 留空时沿用会话模型;要填就两个都填,且须是 DSH 中已注册的服务商和模型 |
memoryOwner / userName |
Assistant / User |
整理材料中对助手和用户的称呼 |
timeZone |
空 | 留空跟随系统时区;可指定 Asia/Shanghai 等 IANA 时区,用于记忆日期与召回 |
automaticMaintenance |
true |
内容足量后分批后台整理,压缩时处理尾批 |
enabled |
true |
记忆总开关;关闭保留数据,暂停采集、召回、整理及提示词替换 |
offPeakOnly |
false |
自动整理仅在 offPeakSchedule 允许的时段执行 |
offPeakSchedule |
北京时间波谷时段 | timeZone、weekends 和 windows: [{start, end}];时段使用 HH:mm,结束时间可为 24:00 |
batchedCompaction |
true |
较长的压缩材料分段摘要后合并 |
compactionBatchCharacters |
0 |
0 表示按压缩模型容量自动分批;也可填写不小于 4000 的字符上限 |
compactionConcurrency |
3 |
分段压缩的最大并发请求数,范围 1–8 |
archiveBatchCharacters |
12000 |
每批正文的目标字符数;优先在完整回复边界分批 |
archiveBatchMessages |
100 |
每批完整消息条数上限;字符数或条数任一达标后等待后续一轮,再分批整理 |
archiveContextCharacters |
12000 |
前文与后续一轮各自的参考字符预算 |
archiveRequestCharacters |
64000 |
单次抽取请求的总字符上限,包含提示词、Schema 和前后文 |
consoleEnabled |
true |
允许按需启动本机的记忆审核台 |
recallLimit |
5 |
单次检索返回的候选数,范围 1–10 |
recallMaximumCharacters |
12000 |
单次检索结果的字符上限,范围 1000–48000 |
embedding |
null |
向量检索配置,null 表示不启用 |
更多字段
| 字段 | 默认值 | 范围 |
|---|---|---|
analysisTimeoutMs |
180000 |
1000–600000 |
analysisMaxTokens |
32768 |
256–64000 |
maximumOutputCharacters |
262144 |
1024–2000000 |
maximumInputBatches |
2 |
1–20 |
maximumMaintenanceTasks |
10 |
1–100 |
maximumStateRequests |
10 |
1–100 |
maximumConsolidationRuns |
3 |
1–20 |
historyBatchSize |
128 |
1–1000 |
embedding.timeoutMs |
30000 |
1000–600000 |
用配置文件设置 Embedding 时,可以用 embedding.apiKeyEnv 指定一个环境变量名,从启动 DSH 时的环境中读取密钥,避免把密钥写进文件。
完整定义见 src/config.mjs。
开发与打包
npm ci --ignore-scripts
npm run check
npm test
New-Item -ItemType Directory -Force ./dist
npm pack --pack-destination ./dist
执行后会生成 dist/dsh-suzu-memory-0.6.0.tgz,按快速开始安装即可。测试包含 DSH 官方运行时的集成测试,使用受控的模型适配器,不需要真实的 API Key。
dsh-suzu-memory/
├── src/
│   ├── index.mjs            插件入口:事件订阅、命令、检索工具
│   ├── runtime.mjs          会话与记忆服务的生命周期
│   ├── events.mjs           DSH 会话事件 → Suzu Memory 事件
│   ├── generator.mjs        让 Suzu Memory 调用 DSH 的模型
│   ├── session-settings.mjs 会话开关、人设与压缩提示词
│   ├── compaction.mjs       压缩指令与分段摘要
│   ├── schedule.mjs         后台整理时段
│   ├── memory-page/         独立图谱页面,与原生审核台切换
│   ├── config.mjs           配置定义
│   └── client.js            设置页界面
├── vendor/suzu-memory/      Suzu Memory 核心快照(与上游一致)
├── test/                    单元测试与 DSH 集成测试
└── UPSTREAM.json            上游仓库与固定提交
适配代码都在 src/,vendor/suzu-memory/ 下的核心算法源码不做修改,上游版本和固定提交记录在 UPSTREAM.json。安装包通过 bundled dependencies 携带所需的 Memory 包及其资源。
docs/images/retrieval*.svg 与「记忆系统」一节的原理说明固定在所链接的上游文档版本;内置引擎源码的版本以 UPSTREAM.json 为准。
Apache License 2.0 · 上游许可见 vendor/suzu-memory/LICENSE · 作者:儿玉诚也