dsh-tool-humanize
Verifieddsh-tool-humanize · v0.1.0 · Apache-2.0 · Web UI
humanize_text tool + 去AI味 panel and settings for dsh web: rewrite a draft with the humanizer model — official prompt, hz chunking, keep-verbatim, number/copy/language checks, candidates
Install
dsh plugin add dsh-tool-humanize Confirm the layer applied with dsh --profile default --dump-config — see the install guide.
Source
Published to npm without a public repository. Inspect the package contents before installing.
Tags
Creators
Readme
dsh-tool-humanize · 去 AI 味改写
给 DeepSeek Harness(dsh) 用的插件:把一段"一看就是 AI 写的"草稿,交给 humanizer 改写模型,改成更像人写的样子。名字、数字、链接这些不该动的地方会原样保留。
装好之后你会得到两样东西:
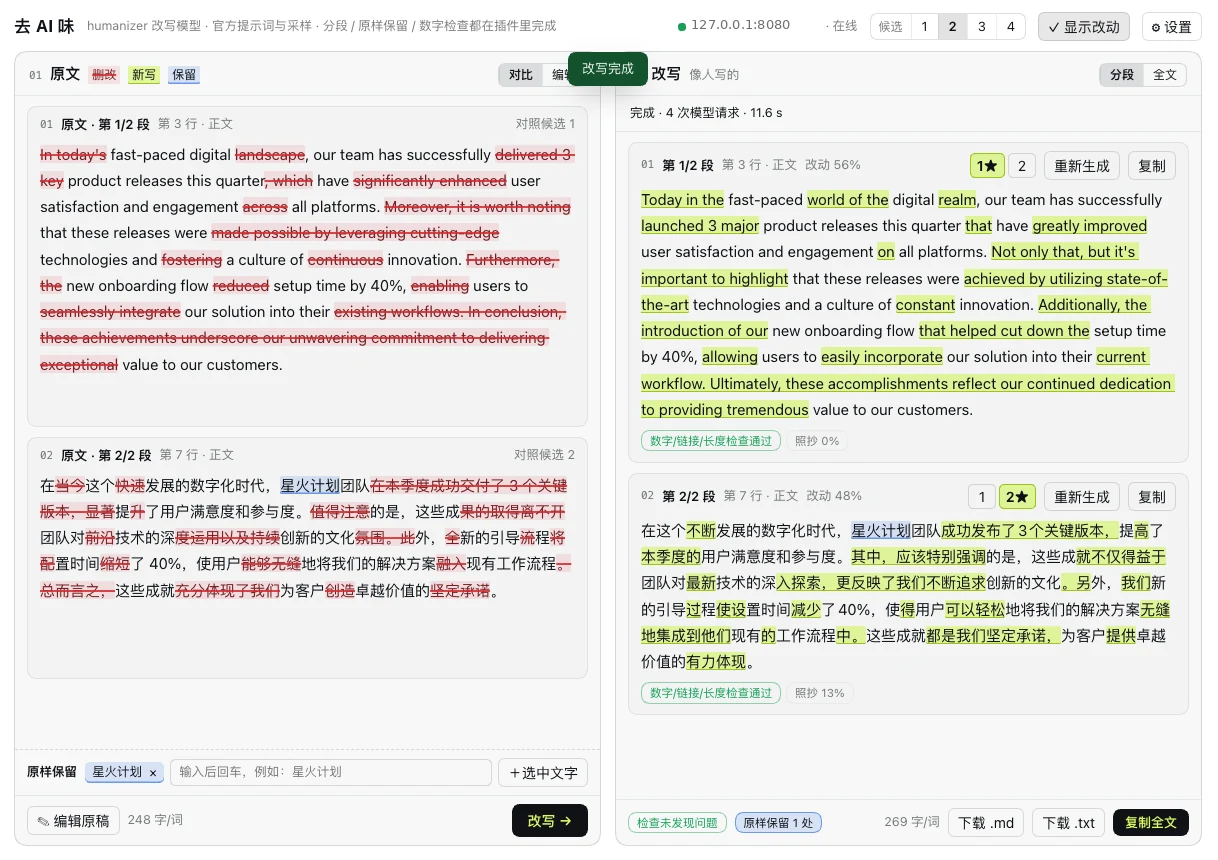
- 「去 AI 味」面板:在 dsh web 左侧栏打开,左边贴原文,右边看改写,改了哪里一眼就能看出来。
humanize_text工具:在对话里直接说"帮我把这段去去 AI 味",主模型会自己调用它,不会自己瞎改。
开始之前:准备一个 humanizer 服务
这个插件只负责"怎么用",模型需要你自己跑起来。最简单的做法是用 llama.cpp 的 llama-server 加载 humanizer 的 GGUF:
llama-server -m humanizer-12b-Q8_0.gguf --host 127.0.0.1 --port 8080 -np 1
# 想加访问密钥的话:--api-key-file <你的密钥文件>
12B 的 Q8_0 大约要 13 GB 显存;显存紧张可以用 Q4_K_M。服务起来后,浏览器打开 http://127.0.0.1:8080/health 能看到 ok 就行。
安装
dsh plugin --profile web add dsh-tool-humanize
把 web 换成你自己用的 profile 名即可。装完重开 dsh web,左侧栏会多出「去 AI 味」。
配置
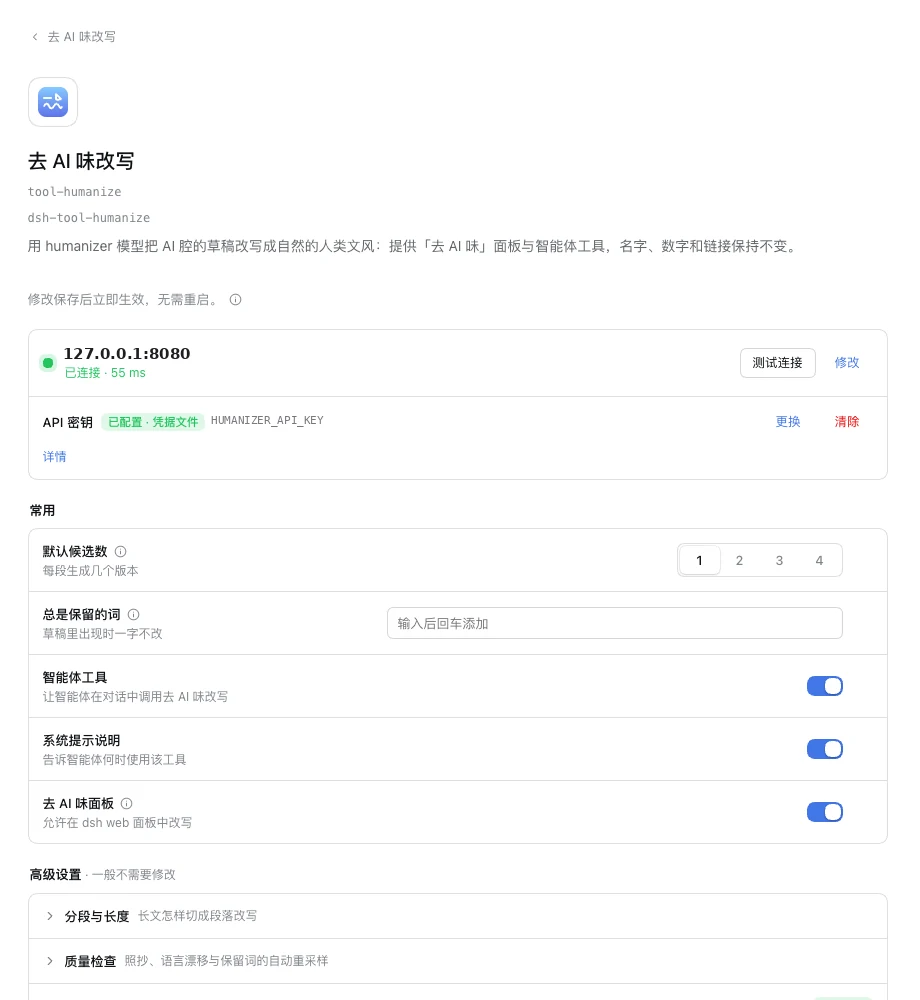
默认连接 http://127.0.0.1:8080。服务在别的机器上、或者设了密钥,就去 插件 → 去 AI 味改写 → 配置(面板右上角的 ⚙ 设置也是同一个页面):
- 填「服务地址」,点「测试连接」,看到绿点就说明连上了;
- 有密钥的话点「更换」填进去——密钥存在 dsh 自己的凭据文件里,页面上只显示"已配置",不会回显;
- 其他选项基本不用动,改完点保存,立即生效,不用重启。
也可以直接写进 profile 的 cordis.patch.yml:
- id: tool-humanize
  name: dsh-tool-humanize
  config:
    baseURL: http://你的服务器:8080
    apiKeyEnv: HUMANIZER_API_KEY   # 凭据的名字,不是密钥本身
怎么用
在面板里改
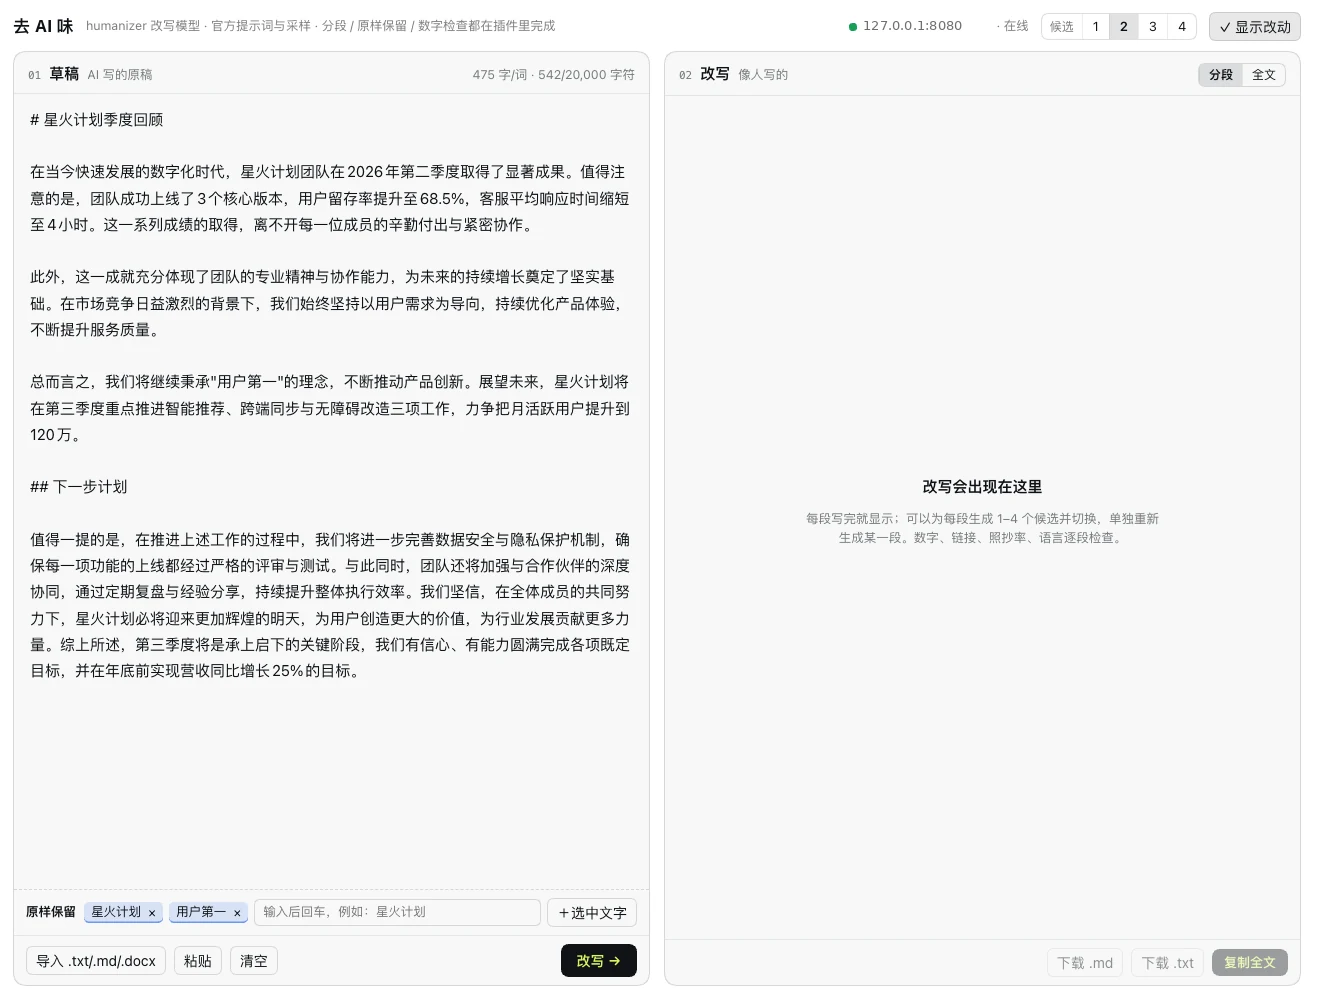
- 把草稿贴进左边,或者导入
.txt/.md/.docx; - 有不想被改的词(产品名、人名、术语),在「原样保留」里加上,或者在原文里选中后点「+选中文字」;
- 选每段要几个候选(1–4),点「改写」(⌘/Ctrl + Enter)。
改写过程中右边会边写边出来。读结果时:
- 左边红色删除线是被改掉的原文,右边绿色高亮是新写的部分,蓝色是原样保留的词;
- 每段下面有自动检查:数字、链接有没有丢,是不是照抄太多,有问题会提示;
- 多个候选时用
12切换,★ 是检查结果最好的那个;不满意可以单段「重新生成」; - 「全文」视图可以一键复制,或下载成
.md/.txt。
在对话里用
直接跟 dsh 说就行,比如:
帮我把下面这段去一下 AI 味,"星火计划"保持不变:……
主模型会调用 humanize_text,把改写结果原样给你。
好用的地方,和要注意的地方
- 长文会按段落、标题自动切块分别改写,Markdown 结构不会乱;
- 改写有随机性,同一段多生成几次,挑一个最顺的;
- 英文效果最好。中文能用,但改动偏保守,偶尔会把数字格式改掉,交出去前扫一眼右下角的检查提示;
- 适合邮件、帖子、说明类文字;公文、新闻这类本来就要求规整的文字,收益不大。
常用设置一览
| 设置 | 默认 | 说明 |
|---|---|---|
服务地址 baseURL |
http://127.0.0.1:8080 |
llama-server 地址,末尾的 /v1 会自动去掉 |
密钥 apiKeyEnv |
HUMANIZER_API_KEY |
凭据名;服务没设密钥可以不管 |
默认候选数 defaultSamples |
1 | 每段生成几个版本(1–4) |
总是保留的词 defaultKeep |
空 | 每次都自动原样保留 |
最长输入 maxChars |
20000 | 超过会提示拆开改 |
照抄阈值 maxCopy |
0.5 | 改动太少会被标出来 |
| 智能体工具 / 去 AI 味面板 | 开 | 可以单独关掉其中一个 |
采样参数、分段长度、超时重试等都在设置页的「高级设置」里,默认就是模型作者推荐的值,一般不用改。
致谢与许可
提示词格式、分段和检查逻辑移植自 humanizer 官方应用,模型来自 jialinyyzz/humanizer。本插件以 Apache-2.0 发布,详见 LICENSE 与 NOTICE。