dsh-model-router
Verified@neptune810/dsh-model-router · v1.0.0 · MIT · Web UI
Model router for DeepSeek Harness: keep a pool of models and every step is routed to one of them with its reasoning effort set — a click-only composer panel, three authorization scopes (a manual pick only counts in the scope that owns it, and effort scope
Install
dsh plugin add @neptune810/dsh-model-router Confirm the layer applied with dsh --profile default --dump-config — see the install guide.
Source
Tags
Creators
Readme
dsh-model-router
English | 中文
一个 DeepSeek Harness 插件:维护一组模型池, 把每一步路由到其中之一并设定该步的思考等级。思考始终开启——DeepSeek 会拒绝历史中含有 「关闭思考时产生的工具调用」的思考请求。
路由表
| 步骤类别 | 判定依据 | 思考等级 | 底层标量 |
|---|---|---|---|
trivial |
短步骤里的明确廉价意图(翻译、改名、格式化) | low |
~50 |
standard |
普通短请求,无工程线索 | low |
~50 |
engineering |
工程线索 / 代码·diff·XML 结构 / 工具循环 | high |
~75 |
hard |
密集工程简报,或任务内挣来的失败证据 | high(allowMax 时为 max) |
~75 / 100 |
high 是默认上限。V4.1-Flash 底层是一个 1–100 的标量,对外只暴露三个预设名;high 约等于 75,
正是公开曲线仍然陡峭的位置。再往上拉,输出 token 多花约 1.6–1.8 倍,换来的提升却很边际。
v0.15.0 起 routes.<class>.effort 可以写任意一档九词词表(off、none、minimal、low、medium、high、xhigh、max、ultra);目标模型不认识某个词时取最近的一档,等距时向上取(质量优先)。off 与 max 类词仍受规则 5 与 allowMax 两道闸门约束。
授权模式、模型池与任务预设(v0.5)
control 决定插件能改什么,而且手调只在拥有它的那个模式里算数:改思考等级会让
full/effort 让位,但不影响 model;换模型会让 full/model 让位,但不影响 effort。
让位后插件一直不接管,直到你发下一条命令,或在输入栏控件上点「重新接管」。
| 模式 | 控制范围 |
|---|---|
full 模型+思考(Model+Effort) |
模型 + 思考等级 |
effort 思考 |
只作用于你在面板里选中的那一个模型,只调它的思考等级 |
model 模型 |
只调模型,思考等级听你的 |
思考 模式下,面板会先要求你选中唯一一个模型(POST /model-router/effort-model,/state
用 effortModel / effectiveEffortModel 汇报)。没选之前插件完全不接管——既不换模型也不改思考
等级。绑定之后,手动换模型不会让它退出(它只管绑定的那个模型),手动改思考等级才会。
客户端半边以优先级 -1 注册进官方 conversation.input.model 座位,接管 composer 的模型格;它同时
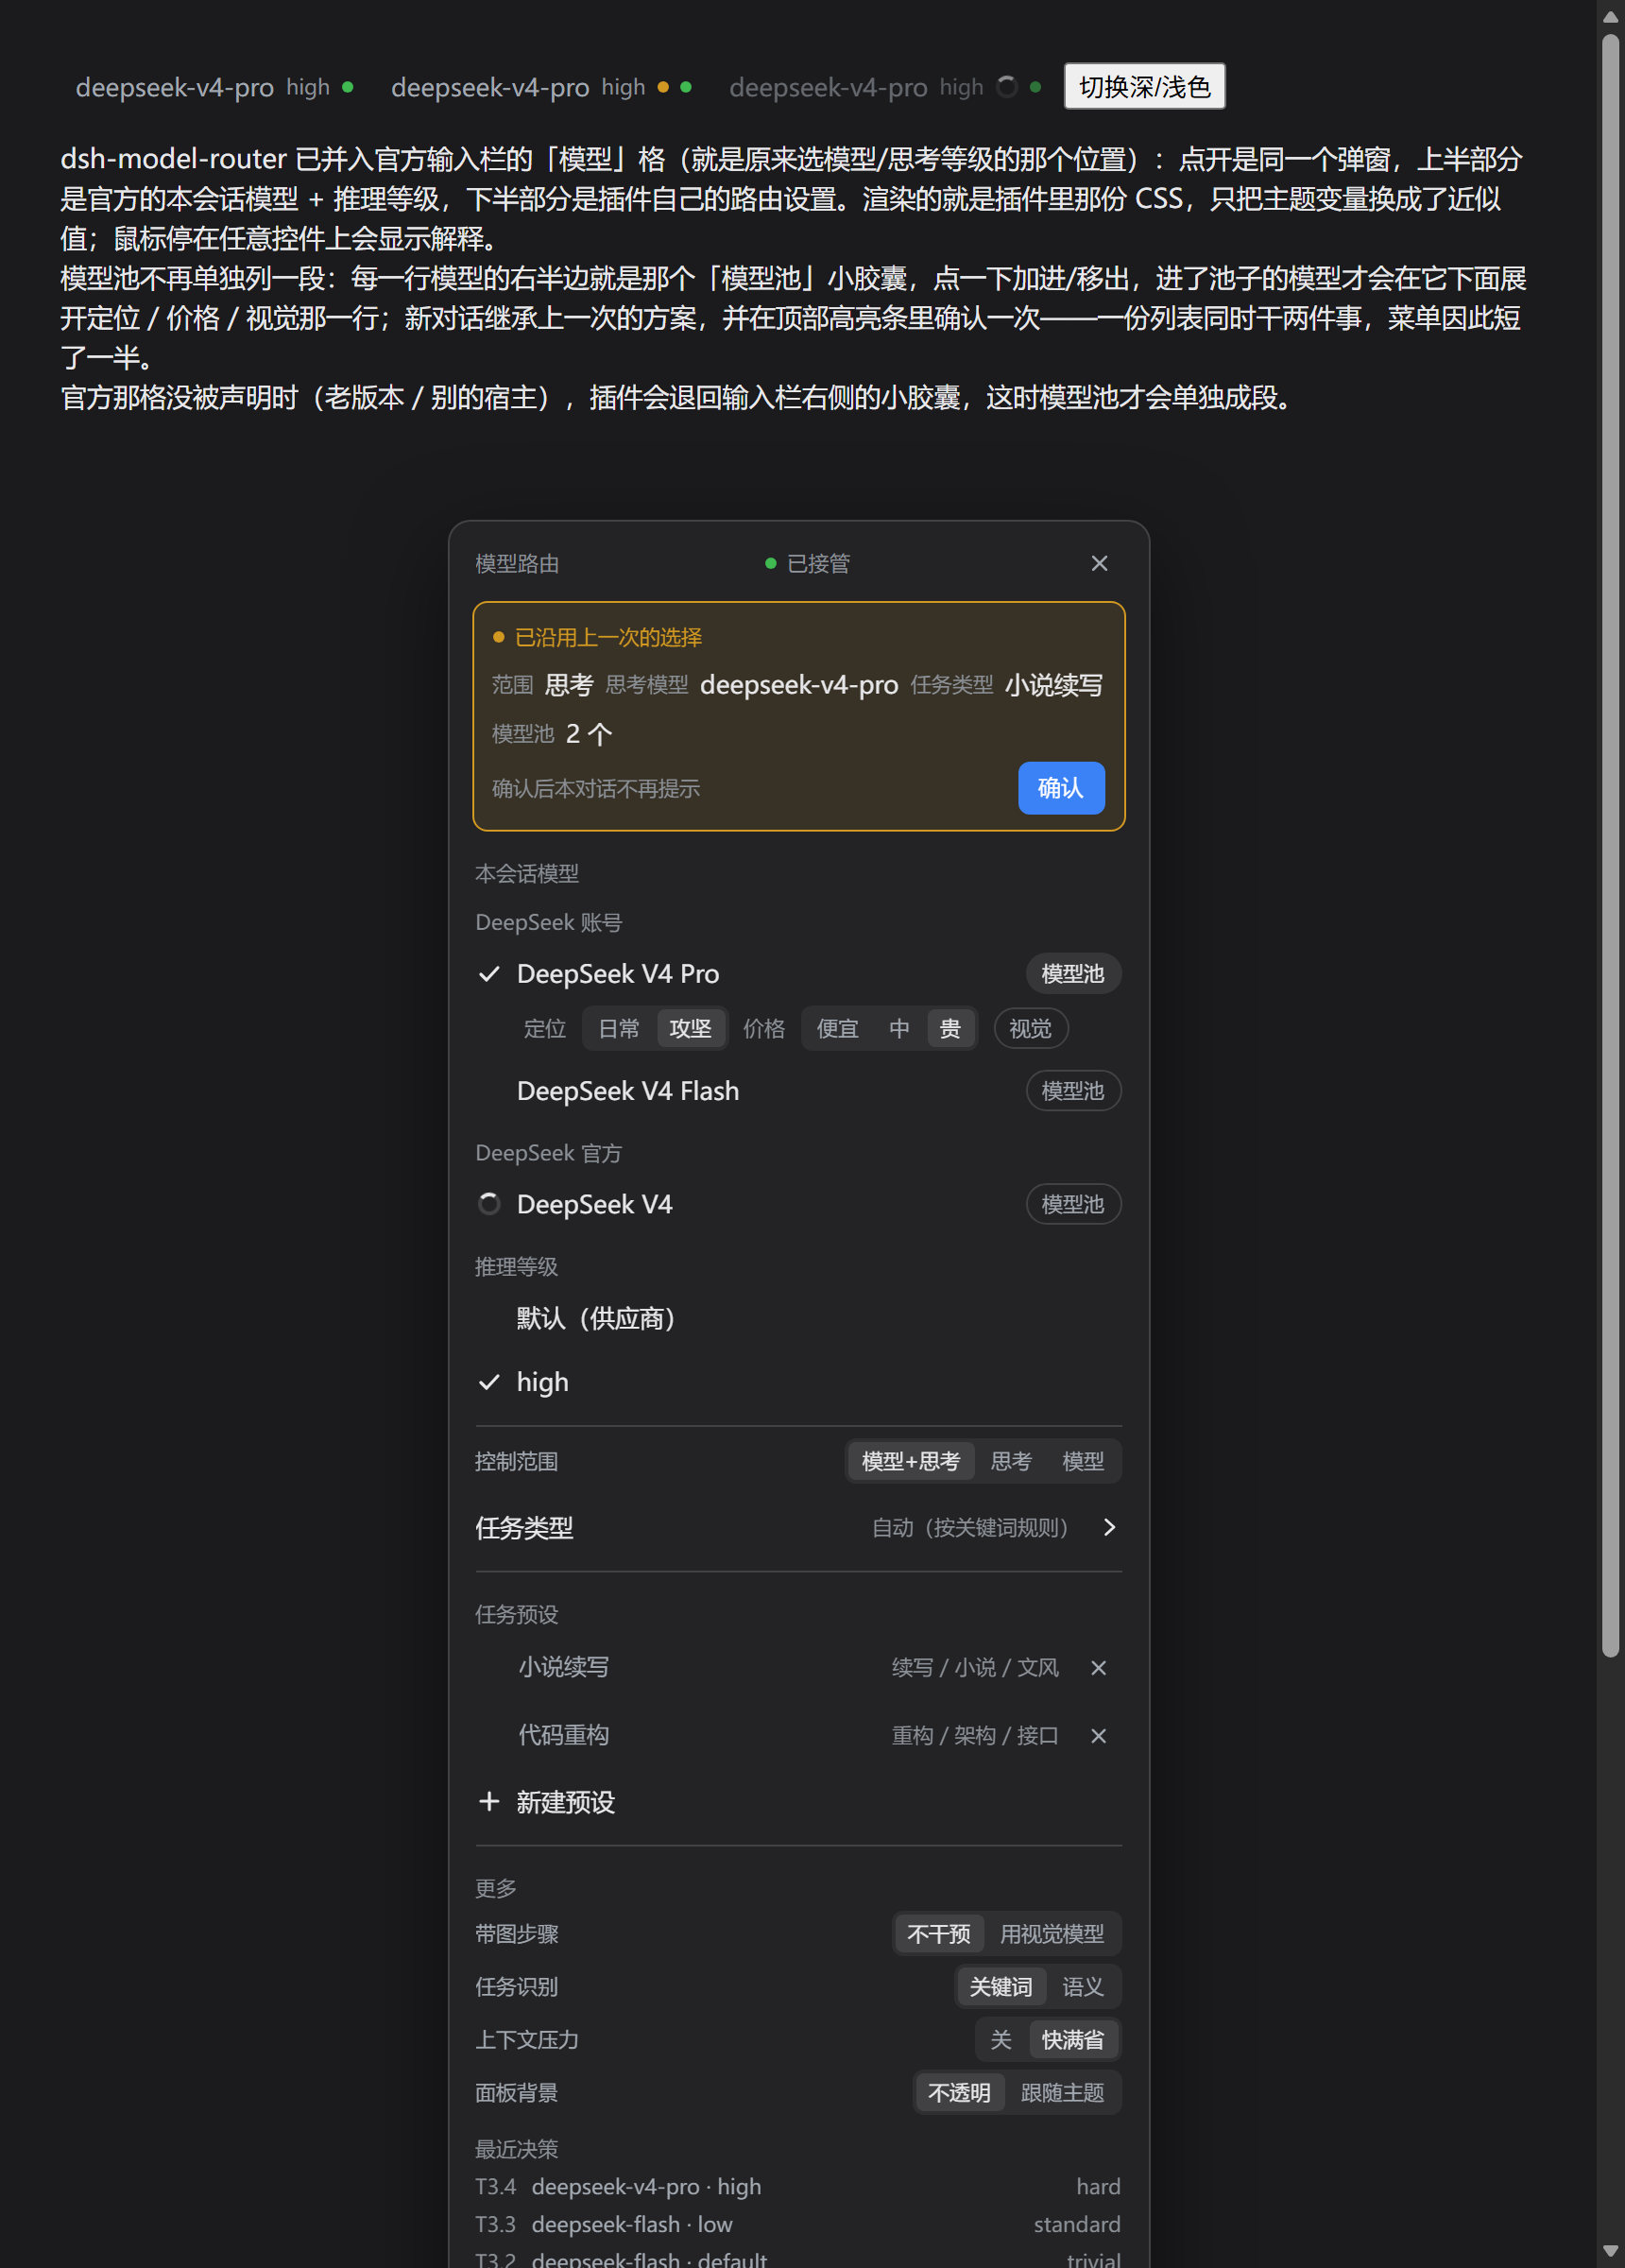
承载官方「本会话模型 + 推理等级」两段和路由器的模式切换、重新接管、任务类型选择与任务预设:模型池已合并进同一份模型列表——每行右侧的
「模型池」胶囊点一下把这个模型加进 / 移出池子,进了池子的行会在下面展开定位 / 价格 / 视觉,池里多出来的模型归到「其他模型」一组,菜单因此短了一半。列表按 provider 分组,每组标题右侧有「全加入 / 全移除」,成本还能用内置规则或 OpenRouter 快照自动填。
所有写操作都走同源 /model-router/* 路由。
模型池:只有池里的模型会被选中。
pool:
  - { id: deepseek-official/deepseek-flash, cost: 1, tier: cheap }
  - { id: deepseek-official/deepseek-v4-pro, cost: 8, tier: strong, maxPerTask: 3 }
  - { id: deepseek-official/deepseek-v4-flash-vision-exp, cost: 1, tags: [vision] }
  - { id: vendor-x/writer-pro, cost: 20, weights: { 小说续写: 95 } }
tier: strong 是困难步骤与证据升级时优先的档位;cost 参与 scoring.costPenalty 扣分;
maxPerTask 限制单个任务能用这个模型几步(可写在条目上,也可在配置层写
maxPerTask.strong 作为所有强档条目的默认上限;两者都不写就是不限)。一旦池中有模型带
vision 标签,带图步骤只在它们之间选。
任务预设:自定义任务类型 + 规则 + 每模型权重。
presets:
  小说续写:
    match: ["续写", "小说", "文风", "/chapter\\s+\\d+/i"]
    weights: { "vendor-x/writer-pro": 95, "deepseek-official/deepseek-v4-pro": 60 }
  代码重构:
    match: ["重构", "refactor", "架构"]
    weights: { "deepseek-official/deepseek-v4-pro": 90 }
在控件里手动选定的任务类型优先于规则;没选才走关键词规则(classifier: rules)。第三方模型用
自己的 effort 词表:插件向 provider 查询它支持哪些档位,取最接近的,模型完全不支持思考时就不发
effort 字段。
默认不透明(主题的菜单色本身是半透明,会把背后的聊天内容透上来):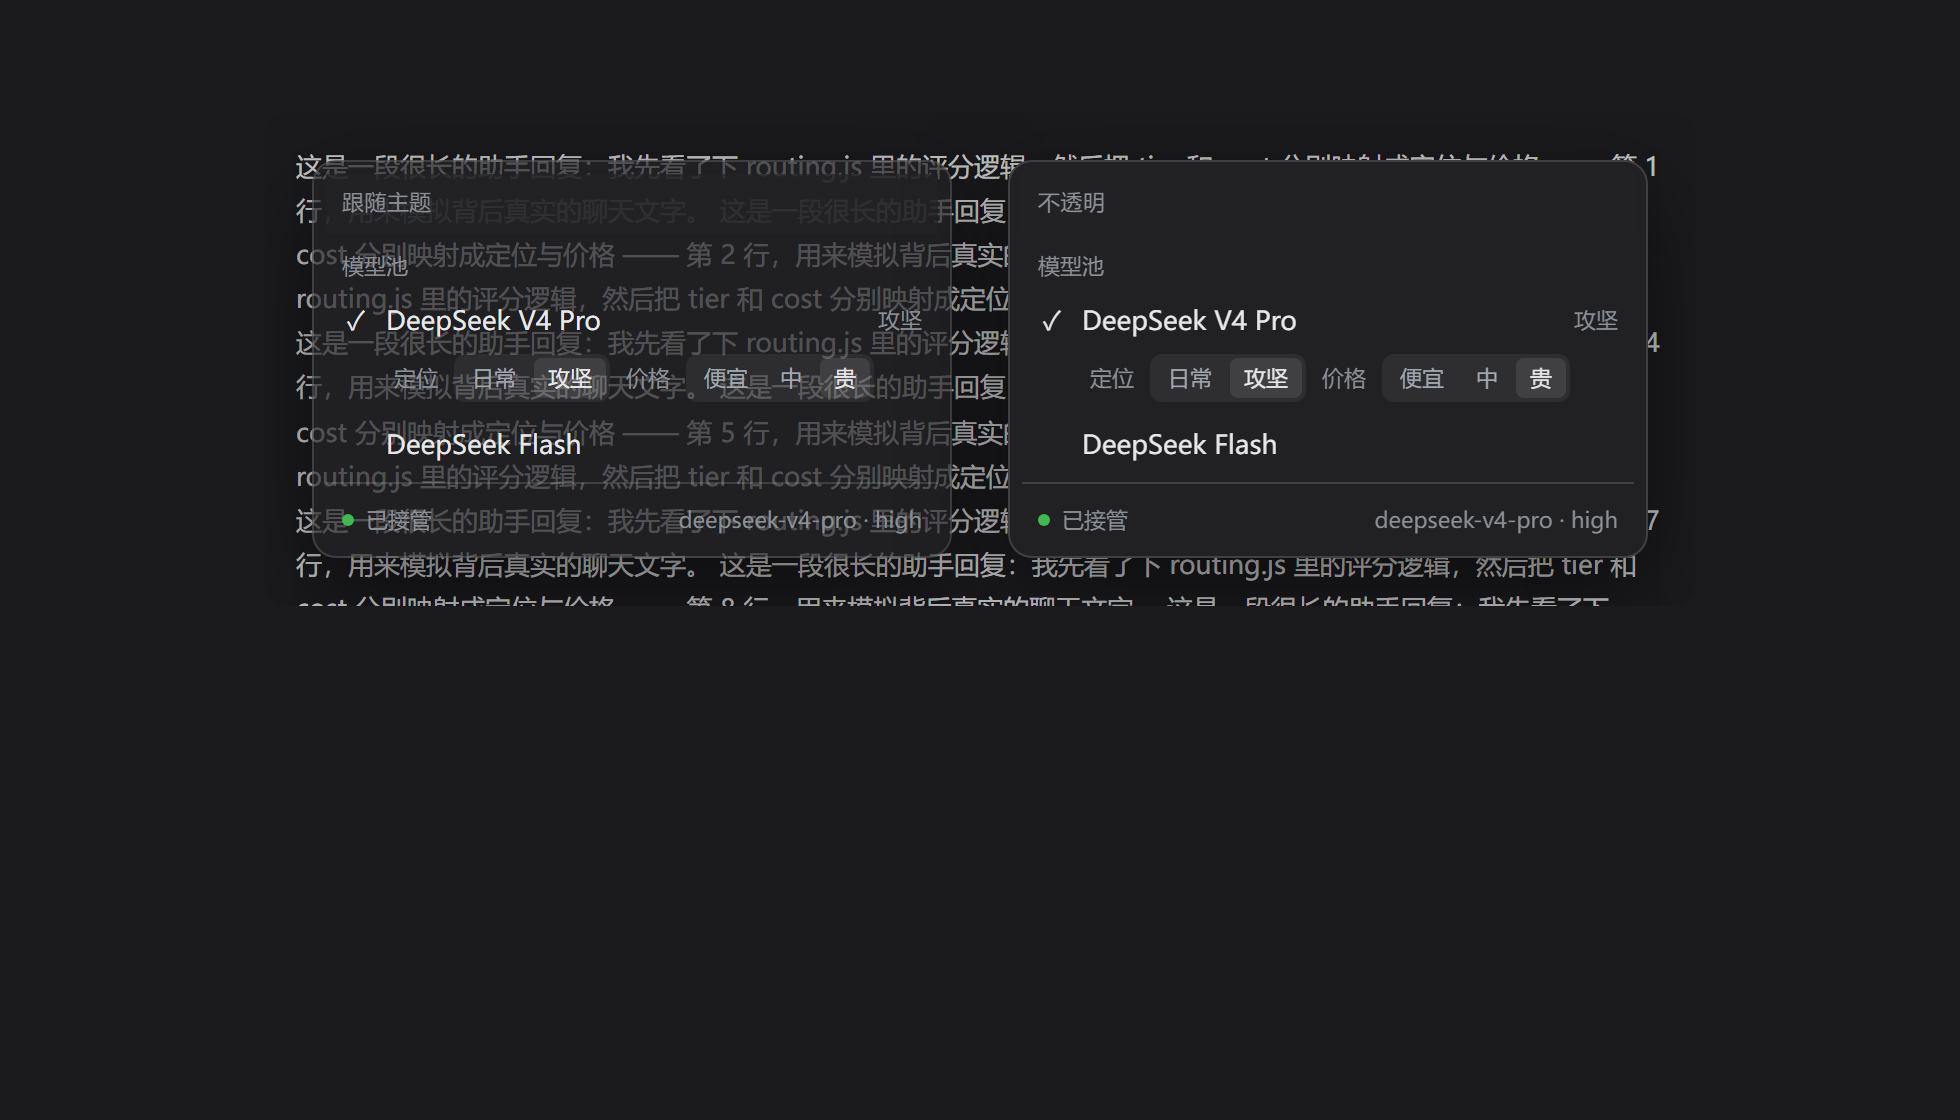
控件就是 composer 的模型格(v0.11.0)
路由器的控件以优先级 -1 注册进官方 conversation.input.model 座位,低于官方 ModelSelect
(优先级 0,来自 @deepseek-ai/dsh-client-ui-model-selection)。槽位引擎渲染优先级最低的那个,所以这个
合并控件接管了 composer 的模型格,输入栏只会出现一个控件,而不是在官方选择器旁边再放一个 chip。
这一个控件同时保留两半。官方那一半是 本会话模型 / Session model 与 推理等级 / Reasoning effort,由真正的
ModelDirectory 驱动(props.directory.store 订阅、props.load()、props.select({ provider, model, reasoningEffort })):provider/模型分组、当前行的对勾、待选行的转圈、供应商默认行、目录加载 / 出错 /
重试,以及官方「模型 · 等级」的触发器文案。下面才是路由器自己的分组:接管状态、控制范围(模型+思考 /
思考 / 模型)、任务类型,然后是模型列表本身——模型池折进模型行:每个会话模型行右侧带一个 模型池 /
Model pool 小胶囊,点它把该模型加入或移出池子,入池的行会在下面展开 定位 / 价格 / 视觉,目录里没有对应
provider 分组的池条目会和「手动填模型 ID」一起归到 其他模型 / Other models。模型行按 provider 分组,每组标题右侧是 全加入 / Add all 与 全移除 / Remove all;面板头部有 自动定价 / Auto price 与 联网定价 / Fetch prices 两个按钮,用来给没手标价格的池条目填 便宜 / 中 / 贵。再往下是 任务预设 与 更多。
所有改动都通过同源 /model-router/* 路由发给宿主;对话区里每次调用的路由行不变。
旧的 conversation.input.right chip(model-router:composer-control,order 20)仍然注册着,但它会
自我收回——座位注册一落地就把自己 dispose 掉——所以正常宿主渲染出的 .right 一列是空的,永远只会看到
合并后的那个控件。只有拒绝或重命名该座位的宿主,才会保留 chip 作为回退。
0.10.0 第一次尝试这么做,0.10.1 已回滚:现场那个座位整格空白,而且一次重启直接启动失败。根因是 cordis
解析 remote.session 这类嵌套服务时,会从调用方所在的 fiber 往上走,所以客户端插件自己必须先在插件级声明
sessions、remote 与 remote.session,之后方法才能碰 ModelDirectory.directoryFor()。插件级 inject 现在
是 ["slots", "uiConversation", "sessions", "remote", "remote.session"]。
限制。 这是注册进官方座位,不是给官方组件打补丁:官方弹层的内部实现(portal 菜单、搜索框、键盘导航、
模块 CSS)没有被复制,只复刻了它的选择语义。如果某个 DSH 不再声明 conversation.input.model,座位注册会静默
失败,小号的回退 chip 接管。插件源码改动仍然需要完整重启 dsh web / 桌面端。
新对话继承上一次的方案并确认一次(v0.13.0)
以前每次启动 DSH 面板都会回到默认值,每个新对话也各按各的来。现在宿主会记住你最后一次设定的方案——控制
范围、绑定的思考模型、钉住的任务类型——存在 <profile>/.model-router/state.json 的 last 里;自己还没做
过选择的对话就沿用它。选择仍然是分对话的:某个对话一旦自己配过,就以它自己的 sessions 条目为准,对话之间
互不影响。
继承来的方案不是你在这个对话里做的决定,所以面板顶部会先出现一条警示色高亮条:有可继承的东西时是
「已沿用上一次的选择」,什么都没有时是「新对话:先确认这次的路由方案」。条上列出生效的 范围 / 思考模型 /
任务类型 / 模型池,以及一个「确认」按钮(POST /model-router/confirm { sessionId, plan });没确认之前
composer 触发器上会有一个脉冲的黄点。确认会把这个方案键记到该会话上——/state 回报 plan、planKey
与 planConfirmed——此后本对话不再出现高亮条和黄点;改动控制范围、绑定模型、任务类型或模型池都会产生不同
的键,于是再确认一次。
多品牌:分组、自动定价与跨品牌确认(v0.14.0)
以前池子一行一个模型平铺,换第二个品牌要点很多次。现在模型列表按 provider 分组:官方目录的每个分组、 以及「其他模型」里每个品牌,标题右侧都有「全加入 / Add all」和「全移除 / Remove all」,一次把整个品牌的 模型放进 / 拿出池子。
成本不再必须手标。内置的相对价格分类器(lib/pricing.js,纯函数、无依赖)按模型名给出 便宜 / 中 / 贵
(cost 1 / 4 / 8),覆盖常见的 DeepSeek、OpenAI、Anthropic、Google、Qwen、Llama 家族;「自动定价」用它
加上已存的 OpenRouter 快照,联网定价先拉一次 OpenRouter 快照(20 秒超时)再定价。每条池条目的
costSource 记录来源(builtin / openrouter / manual),你手标过的那条永远不被覆盖。
跨品牌切换本身也变成一个决定。跨品牌 / Cross-brand 有三个取值:允许 / 先问 / 禁止(默认先问)。选「先问」
时,如果下一步想用的模型属于另一个品牌,宿主先留在当前品牌,把候选放进 state.cross.proposal,面板顶部
弹出提议条,三个按钮分别对应 只切一次 / 本会话允许 / 不再跨品牌。池子里只有另一个品牌的模型时照常路由(守卫
只在存在同品牌备选时才拦),迟滞记忆也不会再把被拦下的模型放回来。
对应路由:POST /model-router/cross { sessionId, action }(action 取 allow / once / never)、
POST /model-router/pool/auto-price { fetch }、POST /model-router/prices;/state 增加 cross 与
prices。
全部点一点就能配(v0.6.2)
输入栏那个控件就是完整的配置入口,不需要写 JSON/YAML:
| 区块 | 操作 |
|---|---|
| 模式 | 点「模型+思考 / 思考 / 模型」;「思考」下先选中唯一一个模型;手调后会出现「重新接管」按钮 |
| 任务类型 | 选「自动(按关键词规则)」或某个预设 |
| 模型池 | 从实时模型目录里勾选,再用下拉设档位 / 成本 / 视觉 |
| 任务预设 | 点「+ 新建预设」→ 点常用词包(写作/代码/翻译/分析)或输入一个词 → 用下拉给每个池内模型选权重 |
| 更多 | 带图步骤、任务识别(规则/语义)、上下文压力、跨品牌(允许/先问/禁止) |
所有设置通过同源 /model-router/* 路由持久化到 <profile>/.model-router/state.json,行配置只是可选默认值。
每次调用都标出它的路由(v0.8.0)
对话区里每条工具调用后面都会多一行小字,写明这一步实际用的模型和思考等级:
deepseek-official/deepseek-v4-pro · high
宿主把会话自己的事件折进 modelRouterRoute 会话投影(stateVersion 1):request/header 给出当时生效的
provider / model / effort,step/start 给出 turn 与 step,tool/call 把这一对记在这次调用的 callId 上。
effort 为 null 表示默认档由适配器决定,这行就显示本地化的「默认」。投影每个会话保留最近 200 次调用,
超出的从最旧的开始丢。
客户端在每条 tool/call 上注册 model-router-route 会话 Definition,并通过 conversation.chat.node 插槽
渲染,锚在这次调用之后(+0.1)。它防御式地读投影:宿主还没折算出这次调用时什么都不显示,而不是借用别的
调用的路由。这一行是工具调用旁边独立的小字——原因见已知限制。
图片、会话信号、子 agent 与语义分类(v0.6.0)
图片:imagePolicy: vision 会把「带图任务」路由到视觉模型——池里带 vision 标签的模型,或
visionModel 显式指定的那个。图片是任务级的:下一条不带图的命令会回到普通档位。
会话信号:插件读取 DSH 的核心投影来细化判断。
| 信号 | 作用 |
|---|---|
当前 todo(todos) |
参与任务类型匹配——计划项比用户那句话更能说明这一步在做什么 |
| 上下文压力 | 超过 signals.contextPressure(0–1)时偏向廉价档 |
| token 总量 | 超过 signals.sessionTokens(0=关闭)时偏向廉价档 |
delegationDepth |
子 agent 默认走廉价档(subagent.preferCheap) |
每个决策都会记录它看到的信号,所以 /router 和输入栏控件都能解释「为什么这么选」。
/router:打印当前授权模式、是否接管、模型池、任务类型、最近若干次决策以及本任务强档花费;/router replay [n] 打印磁盘上最近 n 条持久化决策(v0.15.0)。
语义分类:classifier: llm 每轮做一次很小的模型调用挑预设(classifierModel、effort off、
classifierTimeoutMs),当轮缓存,任何失败都静默回落到关键词规则;默认仍是 rules。
观测基线:遥测、/stats、/router replay 与 ETag(v0.15.0)
v0.15.0 不改变任何一条路由结果,只先让每个被路由的步骤可观测。
决策遥测。 每个被路由的步骤写一条 router.decision/1 事件到
<DSH_HOME>/storages/model-router/telemetry/decisions-YYYY-MM.jsonl(按月分文件,单文件超过 8 MB 轮转)。事件包含
turn/step、stepClass、score 与 scoreParts 分项、前 5 名候选与分数、实际 chosen
(provider/model/effort/tier/cost)、reason、cross 结果、本步 token 增量与 costUnits、分类器
{used,type,confidence}。不写任何提示词、消息正文或绝对路径;会话 id 先哈希成 sha256: 加 16 位十六进制。
写入按 setImmediate 合并,失败只报一次并关闭遥测,永远不会影响请求返回。DSH_MODEL_ROUTER_TELEMETRY=0 可关闭。
成本口径。 costUnits = 本步 token 增量 × 该模型在池里的 cost / 1e6。这是插件自己的记账单位(便于跨模型
比较与看趋势),不是账单货币;/state.cost 给出 sessionCostUnits 与 taskCostUnits 两个累加值。0.15.1 起
每条事件还会按随包目录折算成美元(usage.costUsd),costUnits 保留为你给每个条目设的相对单位。
GET /model-router/stats?since=&until=&limit=。 把 JSONL 聚合成固定形状:
window{since,until,steps}、byClass、byModel、byEffort、
totals{costUnits,strongSteps,overrideRate,failedEscalations}。默认窗口最近 7 天。它读磁盘上的记录,所以重启不丢、
也能覆盖已经关闭的会话。
/router replay [n]。 打印最近 n 条持久化决策(默认 10,最多 50),每条一行:
时间/turn/step/模型/effort/类别/score/tokens/costUnits/原因。不带 replay 的 /router 仍然打印当前方案。
更省的面板轮询。 面板轮询从 700 ms 改为 1200 ms,并带 ETag + If-None-Match:/state 未变化时返回
304 空 body,不再重复解析大 JSON;/state.stateVersion 是单调计数器,客户端只在它变化时更新视图。旧宿主没有
ETag 时退化为无条件轮询(0.14 行为)。调试可用 DSH_MODEL_ROUTER_NO_ETAG=1 关闭 ETag。
宿主兼容自检。 启动后插件检查宿主契约:sessionProjections 是必需的,webServer/commands/llm
缺失只降级不崩。缺失项以一条 warn 记录,并出现在 GET /state.compat.missing,面板据此提示「当前宿主不完整」。
价格、硬日期与目录漂移(v0.15.1)
v0.15.1 只是把观测变成钱和日期,不改路由:模型、档位、分数都不变,golden 快照与 0.15.0 逐字节一致。
带日期的价格。 catalog/model-catalog.yaml 记录带生效日期的标价(pricing,以及带 effectiveFrom 的
pricing.next)、DeepSeek 的峰谷时段和硬日历。lib/catalog-pricing.js(导出为 ./catalog-pricing)把这些数据
变成数字:
pricesAt(model, at)—— 某一时刻生效的价格。pricing.next在其effectiveFrom当天接管;DeepSeek 工作日 09:00-12:00、14:00-18:00(Asia/Shanghai)按高峰计费,其余时段按五折。tokenSplit(before, after)、tokenCost(split, price)、usdCost(...)—— 把两次累计 token 投影之差拆成一步的 input/output/cacheRead/cacheWrite/reasoning,按模型自己的货币计价,再用目录里的fxRate换算。upcomingAlerts(at, {withinDays})与modelMeta(model, at)—— 窗口内的硬日期,以及目录条目本身。
价格未知一律是 null,永远不是 0:缺 cache-write 价格就回落到新输入价(隐式缓存就是这么计费的),缺
input/output 价格时成本为 null,不编数字。
每条决策都带价。 router.decision/1 增加 usage.split、usage.costUsd 和一份 usage.price 快照(货币、单位、
effectiveFrom、是否高峰、来源、当时生效的四档价格),并且用该步自己的时间戳取价——回放时得到的是当时真实
计费的价,而不是今天的价。
/stats 里的账本。 totals 与每个 by* 行都带 tokens、inputTokens、outputTokens、
cacheReadTokens、cacheWriteTokens、reasoningTokens、costUsd、pricedSteps 与 unpricedSteps。0.15.1 之前写的
事件没有拆分,被计为「未定价」,绝不当成免费。
观察清单与 /state.catalog。 目录顶层新增 watchlist:,记录不在池内的模型的硬日期(第一条是 GLM-4.5
于 2026-12-31 到期);schema、scripts/check-catalog.mjs 与 scripts/build-catalog.py 三层校验,watchlist 的 id
不得与已知模型 id 冲突。GET /state.catalog 返回未来 30 天的 {evidenceDate, withinDays, alerts[{date, description, daysUntil}]};面板在触发器与面板标题各点一个黄点,并在价格说明下最多列三条。
每周漂移报告。 node scripts/catalog-diff.mjs 把随包投影与 OpenRouter 实时模型列表对比,输出 markdown 报告
(--out、--now、--days、--offline <snapshot>、--json、--quiet、--fail-on-drift)。它是建议性的:默认
exit 0,且从不自动改目录,由人更新 YAML。.github/workflows/catalog-diff.yml 每周一 03:00 UTC 运行并上传报告。
成本感知路由:默认关闭(v0.16.0)
0.15.1 知道了「一步花了多少钱」;0.16.0 给候选标价:每个池条目都按随包模型目录算出当步生效的混合
「美元/百万 token」单价,成本项由此可以参与打分。开关默认关闭,所以路由结果不变——十个 golden 快照与
0.15.1 逐字节相同——先交付的是证据:每一步还会记录「若打开成本感知会选谁」,面板与 /stats 都能看出两者
是否一致。
lib/pricing2.js(子路径导出./pricing2)。blendedUsdPerMTok(model, at, mix)按 token 构成给单个 模型算一个混合单价;DEFAULT_MIX是 50% 新输入 / 35% 缓存读 / 15% 输出,而mixFromSplit(split)用真实会话 产生的构成——DeepSeek 会话约 97% 的 token 是缓存读,按默认构成估价会高估约一倍。longContextRates(model, tokens, at)给出当步生效的长上下文档(whole_request整段按长价、excess只对超出阈值的部分按长价),stepCost(model, split, at)给一次split定价、在没有长上下文档命中时与目录价格逐位相同,perCallCost(model, counts, at)按各自的effectiveFrom给 DeepSeek Search/Fetch 这类千次调用行定价。 未知价格一律是null,绝不取 0。- 成本项。
scoring.costWeight(默认 0.15)扣costWeight * 10 * (rate/floor - 1),上限costGuard.maxMultiple - 1(默认 8×)——最多 10.5 分,而hardBonus是 15、engineeringBonus是 8:成本用来 打破平手、微调同档取舍,不会压过任务类别。costGuard.unknownPricing: 'exclude'(默认)对目录无法定价的 条目直接排除而不是猜;hard步骤免于倍数限制;一旦守卫把池清空,路由器会关掉成本感知重试一次 (costFallback)——成本绝不能让会话无路由可用。 - 影子。
costAware关闭时,每一步同时算出成本感知会怎么选并记录下来。GET /model-router/state多了costAware:{enabled, costWeight, guard, mix, floorUsdPerMTok, entries[{id, tier, priced, usdPerMTok, currency, peak}], shadow},其中shadow为{current, candidate, agree, currentUsdPerMTok, candidateUsdPerMTok, savedRatio, currentStepUsd, candidateStepUsd, costFallback}。GET /model-router/stats在同一窗口内汇总:shadow: {steps, agreeSteps, divergedSteps, agreementRate, pricedSteps, currentUsd, candidateUsd, savedUsd, savedRatio}。 - 面板一行。 价格提示下面多一行:
成本影子 (off) · 成本路由会选 X 而不是 Y · 便宜约 N%;两者一致时是成本影子 (off) · 成本路由也选 X;开关打开后是成本影子 (on)。宿主不发costAware块时完全不显示。 - 怎么打开。 在行配置里写
costAware: true(面板暂不提供开关)。此后只要成本项的分差压过原有分差, 同一个配置就会路由到更便宜的那个模型。
渠道健康、预算与峰谷(v0.16.1)
0.16.0 回答「这一步多少钱」,0.16.1 回答「要接这一单的渠道还健康吗、这个会话还允许花钱吗」。三项默认都是
惰性的——channels.failover 关闭、budget.mode: off、peakPolicy: inform(只提示、不改路由)——所以不发
这些块的宿主机行为与 0.16.0 完全一致,十个 golden 快照不变。
- 渠道健康(
lib/channels.js)。 每次路由尝试都记在一个渠道键上:池条目写了channel就用它(同一供应商 的第二个账号就是一个独立渠道),否则用供应商。classifyFailure读宿主的失败码与状态:429/RATE_LIMIT属于「轮换」,5xx/TIMEOUT/TRANSPORT/EMPTY_RESPONSE属于「故障转移」,其它一律不动。ChannelHealth给每个渠道 维护滚动窗口(默认 20 次)与 TTFT 的 EWMA;连续失败 3 次把渠道停用cooldownMs(默认 60 秒),一次成功立刻解除。 冷却只是降序不是拉黑:被冷却的条目沉到健康条目之后但保留分数,所以整池都在冷却时仍然照常路由。 - 故障转移。 默认关闭。打开
channels.failover后,失败的请求通过agent/request-error瀑布返回{kind: 'retry'}——每个 (turn, step) 最多maxFailoversPerStep(默认 1)次——并把刚失败的渠道先停用,使重试不会落回 同一渠道。当当前品牌的全部渠道都被停用时,路由器可以自行跨品牌,但只会跨到目录能定价的条目;crossProvider: 'never'的优先级仍然高于故障转移。 - 指纹与隔离。
fingerprint(observed, expected)检查便宜中转最容易悄悄做错的地方:model与请求不符、usage 缺失或全 0、reasoning_content根本没到、TTFT 超过maxTtftMs。反复不过校验的渠道会被隔离channels.quarantineMs(默认 24 小时),并出现在/state.channels.quarantined与面板里;价格未知的中转绝不自动进入。 - 预算闸门(
lib/budget.js)。budget.mode: 'inform' | 'block',限制项为sessionTokens、sessionUsd、dayUsd、monthUsd,softRatio(默认 0.8)是预警线,限制为 0 表示不限制。block只拒绝合成步骤—— 即不携带新用户消息的一步——通过agent/pre-step返回{kind: 'reject'};用户正在等的那一步永远放行,拒绝只来自 该步本身、不会变成重试循环。POST /model-router/budget(或/router budget [once])放行一步,面板用同一组数字显示用量条。 - 峰谷。 DeepSeek 工作日 09:00-12:00 与 14:00-18:00 收双倍。默认
peakPolicy: inform只在面板与/stats说明;shift额外只对委派(子 agent)步骤把高峰价条目降序——用户正等着的那一步绝不因为价格被推迟或降档。 - 跨品牌提案要有理由。 0.14.0 只要品牌不同就会问;现在只有比同品牌最优条目明显更好(
crossCost.scoreMargin,默认 5 分)或明显更便宜(crossCost.maxMultiple,默认 3 倍),或者同品牌已经无条目可用时才提提案。提案带上savingMultiple与原因,跨品牌步骤仍然全部写入遥测。 - 面板。 目录黄点旁多一个预算点(
data-budget=near|over)、一块带用量条的开销面板、一行峰谷提示,以及一行列出 被冷却与被隔离的渠道。宿主不发这些块时全部不显示。
channels:  { failover: false, failThreshold: 3, cooldownMs: 60000, quarantineMs: 86400000, fingerprint: true }
budget:    { mode: off, sessionTokens: 0, sessionUsd: 0, dayUsd: 0, monthUsd: 0, softRatio: 0.8 }
peakPolicy: inform    # off | inform | shift
crossCost: { maxMultiple: 3, scoreMargin: 5 }
思考等级经济学(一):阶梯可审计(v0.17.0)
档位阶梯原先藏在打分代码里,现在独立成模块(lib/effort.js,子路径 ./effort),于是「我要的是 high、实际跑的是不是 high」对每一步都有答案。
LADDER 是文档化的八档——off(0) minimal(25) low(50) medium(62) high(75) xhigh(86) max(100) ultra(105);
budgetForTier(tier, meta) 把档位换算成 token 预算(low 2048 … max 32768),默认表 DEFAULT_BUDGETS 可被模型通过 catalog 的
effort.budgets 覆盖,并始终受 maxOutput 夹取。以 token 预算表达深度的宿主可直接使用;DeepSeek 的线上只认词表,所以预算在那里是一句能力声明。
每一步都记录档位是怎么落地的。 explainMapping(tier, applied, meta) 区分四种结果:
why |
含义 | 例子 |
|---|---|---|
exact |
模型原样接受该档位 | low → low |
alias |
模型词表更短并有别名 | DeepSeek 的 medium → high |
nearest |
词表里没有这个档位,取最近的(同距取更高) | Kimi 的 xhigh → max |
none |
模型根本不声明思考等级 | high → 无 |
结果写进决策事件 effortMapped,随阶梯与分值发布在 /state.effort,并在不是 exact 时追加到路由的 reason —— 塌缩绝不静默。
/stats 会统计它:顶层 totals.mappedSteps 与 totals.mappedShare,按任务类型的 effort.byClass,以及最常见的 from->to:why 组合
effort.top。面板在「上一步的档位不是原样落地」时补一行(data-mr-effort),原样落地时完全不显示。
离线回放。 /router replay [n] 打印已记录的决策;npm run replay 则用当前代码与当前池,对同一批流量重新求解:
node lib/replay.js                       # 默认 ~/.dsh/storages/model-router
node lib/replay.js --since 2026-10-20    # 指定窗口
node lib/replay.js --config pool.json     # 试算一个新池
node lib/replay.js --json                 # 机器可读报告
node lib/replay.js --fail-on-change       # 有路由或档位变化时退出 1
这个命令行随包发布(npx dsh-model-router-replay,或安装后 node node_modules/@neptune810/dsh-model-router/lib/replay.js);npm run replay 只是仓库内的快捷方式。
默认池取自流量本身,所以「零变化」就等于证明当前代码能复现历史路由;把 --config 指向权重不同的池,回答的是「上周有多少步会路由到别处」。
有两件事它按设计不做:分类与预设都要读提示词原文,而遥测从不存提示词,因此回放把记录下来的 stepClass 当作已知条件,且不重新套用预设。
本版不做的事。 costAware 默认仍是 false:翻默认要等 G3/G4(≥7 天且 ≥300 步影子样本,且至少重启到记录影子的构建上)。
反馈闭环、分类器 v2 与 ε-greedy 放到 0.17.1,与决定要不要翻默认的 L2 实验一起做。
反馈闭环、敢说「我不确定」的分类器、以及探索(v0.17.1)
质量路由需要一个用户按一下就能给出的信号。面板现在在被评判的那条路由下面带三个标签(data-mr-feedback,即
FEEDBACK_LABELS 的「太贵 / 太弱 / 正好」),按下任意一个会 POST /model-router/feedback,体是 { sessionId, label }。
数据不出本机:判定追加到 <storages>/model-router/telemetry/feedback.v1.jsonl,与决策账本放在一起;下一步路由会回答它 ——
下一步走的还是被评判的那条路由时记 outcome: "stayed",换了就记 "moved"。这一对就是 L2 实验要的弱信号:说了「太贵」、
下一步被换到便宜模型,用户等于回答了这句话是抱怨还是请求。
/stats.feedback 按文件聚合而不是按会话:总数与各标签计数、overrides(所有非 just-right 的标签)及其占比、
outcomes(有多少被回答、其中多少真的换了路由),以及 byClass —— 于是「总是被判太弱」的任务类型与「总是被判太贵」的
任务类型会并排出现。
分类器可以说「我不确定」(lib/classifier2.js)。 parseVerdict 从模型的散文里抠出结构化结论
({ class, confidence, family, evidence, signals }),decideVerdict 把它变成一个带 source 的决定:置信度过
classifierMinConfidence(默认 0.6)才采用模型的分类;低于阈值时上调一档而不是猜,并在面板上说明
(data-mr-classifier)。调用本身有界 —— classifierAttempts(2)次尝试、classifierTimeoutMs(2000)—— 熔断器在
连续三次失败后打开,接下来十分钟只用规则。/state.classifier 发布结论、escalate 标记与熔断器快照:分类器在失败
是事实,不是悄悄退回 unknown。
探索是开关式的,也是可复现的(lib/experiments.js)。 experiments.enabled 默认 false;打开后 planExperiment
每一步抽一次签,且只在既非 hard 也非 engineering 的步骤上抽 —— 路由本来就有把握的步骤不是学习的地方。apply 也默认
false,所以默认抽签只是影子:照常记录(/state.experiments.last、/stats.totals.experiments、决策事件里的
experiment 字段),但路由不动。seed 让一次运行可复现,epsilon(默认 0.1)是探索比例;抽签真的接管了这一步时,
面板会点名那条臂。
classifier: llm            # 默认 rules
classifierMinConfidence: 0.6
classifierTimeoutMs: 2000
classifierAttempts: 2
experiments: { enabled: false, apply: false, epsilon: 0.1, seed: null }
本版不做的事。 costAware 默认仍是 false:翻默认要等 G3/G4(七天、300 步已定价的影子样本、且至少重启到记录影子的
构建上一次),本仓库如实记录这条门槛,而不是假装已经达到。在此之前,npm run replay 才是用真实流量回答「要不要翻」的
诚实办法。
1.0.0 到底承诺了什么(v1.0.0)
1.0 承诺的是「什么不会再变」,所以这一版主要是把既有表面写清楚、测住,而不是加能力。
- 带版本的信封。 面板路由的每一个 HTTP 应答——包括传输层自己产生的 403 / 405 / 400——现在都带
"schemaVersion": 1。读方可以拒收看不懂的信封,而不是猜;docs/api.md记录了 15 条路由与package.json#exports发布的模块入口。 - 契约是被测的,不只是被写的。
test/contract.test.js会在这些情况失败:docs/api.md与已注册 路由不一致、插件监听的宿主事件没出现在docs/compat.md、某个导出解析不到或跑出了发布目录、 以及任何应答丢掉schemaVersion。 - 降级会被点名。
/state.compat报missing(缺了它路由跑不起来,目前只有sessionProjections) 与optional(webServer、commands、llm)。面板会用对话语言列出缺了什么,于是「宿主太旧」 表现为一条明确的缺陷,而不是看起来正常、功能却什么也没做。 - 升级路径不需要迁移。
docs/migration-0.14-to-1.0.md列出 0.14.2 以来新增的每一个配置键,说明 无需迁移(状态文件按原样读),并记录唯一一个形状变化的默认值:peakPolicy从inform起步, 而它只会打印。 - 1.x 内只增不改。 minor 版本可以给模块加导出、给
/state加字段;删掉或改变含义要等到 2.0。 发布机制见PUBLISHING.md,改动必须通过的检查见CONTRIBUTING.md,插件存了什么、绝不读什么见SECURITY.md。
这一版故意不含:把浏览器包拆成构建产物、以及面向两个宿主版本的 CI 矩阵。两者都是不改变路由结论的
基础设施工作,都在 PLAN.md 里如实记为顺延,而不是靠版本号暗示已经做完。
五条规则
- 无棘轮。 轮次深度默认不贡献任何分数(
scoring.turnPerPoint: 0),工具调用按「当前任务」 计数。长 agent 循环不会漂向最贵的档位——跑得久 ≠ 任务难。0.9.0 起工具循环只是评分信号,不再单独把类别钉在engineering(scoring.toolCallClass)。 - 升级要证据。 当前任务里累计
escalateOnErrors个失败的工具结果,或同一个工具调用用相同 参数重试escalateOnRepeats次,才升一档,每个任务最多升maxEscalations档。其它任何东西 都不能抬高等级。 max是选项。 除非打开allowMax,auto 模式永远不会发出max。这条在 effort 层面强制, 就算有人在routes表里手写effort: max也会被压回来。- 手动选的
max同样降级(demoteManualMax),但只针对本插件管理的模型,别的模型一律不碰。 打开allowMax会同时关掉这两个钳制。 - 思考必须一直开着。
off不再是自动路由。DeepSeek Messages API 会拒绝这样的请求:开启思考 时,历史里存在一条「关闭思考时产生的、带工具调用」的 assistant 消息(报The content[].thinking in the thinking mode must be passed back to the API)。廉价步骤照样可能 调用工具,而同一任务的下一步就是 engineering 工具循环,于是「一步 off、下一步 high」直接让本轮 失败。现在trivial走low,任何配置或手动选择的off都会被抬到low,除非打开allowThinkingOff。补救: 如果某个会话里已经存在这种「无思考的工具调用」消息(旧版本或手动选off留下的),路由器会识别出来并让该会话保持off(否则每一步都会失败),同时只提醒一次。想恢复 思考就压缩该会话或新建会话。
任务边界取自 agent/inbox/claimed——那才是真正开启一件新工作的事件。上一个任务以未解决的失败
收尾时,下一个任务只继承「犹豫一档」,且只对 engineering / hard 生效。一句「翻译一下」不会继承
上一次的崩溃。
工具循环不再把档位钉在 high(v0.9.0)
0.9.0 之前,classifyStep 只要发现某个任务的步骤里已经出现过工具调用,就把它判成 engineering
(线索是 agent tool loop),而 engineering 走 high。任务级的工具计数器只在下一条用户命令被
领取时清零,所以从第一次工具调用到最后,整个 Agent 过程都停在 high。中途也降不下来:trivial
要求既有廉价意图又不超 60 token,standard 要求工具调用数为 0,工具一直在来就都够不着。而在默认
allowMax: false 下 max 会被压回 high,于是 hard 和 engineering 实测一样贵——已经处于
engineering 的任务再靠证据升级也没有任何变化。
修复前的实测:帮我把这个文件里的日志改成中文 在 0 次工具时是 standard/low,从 1、3、6、12、25
次工具起直到任务结束都是 engineering/high;翻译一下这句话 只要调用过一次工具也会变成 high。
现在由 scoring.toolCallClass(默认 standard)决定「工具循环本身能不能换来 engineering」。
standard 下工具调用照样加分(toolCallBase = 5、toolCallAt = 3、toolCallBig = 8),但类别由
任务本身(强线索或结构化文本)决定,失败与重复调用仍然按证据升级(escalateOnErrors /
escalateOnRepeats)。想恢复旧规则就设成 engineering;其它取值一律回落到 standard。修复后实测:
口语化任务带工具全程 standard/low,工程任务全程 engineering/high。hard 在
allowMax: true 之前依旧压回 high;想直接规定每一档的代价,用 routes.<类别>.effort(例如
routes.engineering.effort: low)。
配置
配置写在该插件行里(profile 的 cordis.patch.yml):
- id: model-router
  config:
    mode: auto            # auto | off
    model: deepseek-flash
    allowMax: false       # true 时 auto 与手动选择都放开 max
    maxFallback: high     # allowMax 为 false 时 max 压回的目标
    allowThinkingOff: false # true 才重新允许 effort "off"(见规则 5:会打断工具循环)
    control: full         # full | effort | model —— 插件能改什么
    manualOverride:
      yieldOnManual: true        # 手调即让位
      resumeOnNextCommand: true  # 下一条命令自动恢复接管
    pool: []              # 模型池白名单;为空则沿用上面的单模型
    presets: {}           # 任务类型 -> { match: [...], weights: { 模型id: 0-100 } }
    scoring:
      costPenalty: 0.4    # 成本在评分里的扣分权重
      turnPerPoint: 0     # 想让长会话重新变重就调大(不推荐)
      toolCallClass: standard  # 工具循环本身能换来的类别:standard(0.9.0)| engineering(旧规则)
    hysteresis:
      downAfter: 2        # 降档前需要连续几步没有证据
    imagePolicy: keep     # keep | vision —— 带图任务是否路由到视觉模型
    visionModel: null     # 显式视觉模型;不填则用池里带 vision 标签的
    signals:
      todos: true         # 当前 todo 参与任务类型匹配
      contextPressure: 0.75  # 上下文占用超过此比例时偏向廉价档(0 关闭)
      sessionTokens: 0    # 会话 token 超过此值时偏向廉价档(0 关闭)
    subagent:
      preferCheap: true   # 子 agent 默认走廉价档,除非预设权重更高
    classifier: rules     # rules | llm —— llm 每轮做一次小调用
    classifierModel: null # llm 分类用的模型(默认池里第一个)
    classifierMinConfidence: 0 # 低于该置信度的 LLM 分类结果被忽略,回退关键词(0 = 全部接受)
    escalateOnErrors: 2   # 多少个失败工具结果升一档
    escalateOnRepeats: 3  # 同一工具同参数重试多少次升一档
    routes:
      trivial:     { effort: low }   # 这里写 off 也会被抬到 low,除非 allowThinkingOff
      standard:    { effort: low }
      engineering: { effort: high }
      hard:        { effort: max }   # 九词任选;目标不支持时取最近档,等距向上
环境变量 DSH_MODEL_ROUTER=off|auto 可在启动时覆盖 mode。
| 键 | 默认 | 说明 |
|---|---|---|
mode |
auto |
off 时完全透传(手动 max 钳制除外) |
provider |
deepseek-official |
只管这一家 |
model |
deepseek-flash |
唯一被驱动的模型 |
familyPattern |
^deepseek-(flash|v4) |
允许接管的会话模型;pro 会话会被拉回 flash |
allowMax |
false |
max 是否可达 |
maxFallback |
high |
max 被压回的目标 |
demoteManualMax |
true |
是否也降级手动选的 max |
allowThinkingOff |
false |
是否重新允许 off;只适合全程不思考的会话 |
control |
full |
插件能改什么:full / effort / model |
manualOverride.yieldOnManual |
true |
拥有它的那种手调是否让位(见上面的授权模式) |
manualOverride.resumeOnNextCommand |
true |
下一条命令是否自动恢复 |
pool |
[] |
provider/model 白名单,支持 cost/tier/tags/weights/maxPerTask |
maxPerTask.strong |
不限 | 每个强档条目在单个任务内的步数上限;条目自带 maxPerTask 时以条目为准 |
presets |
{} |
任务类型:match 规则 + 每模型 weights |
scoring.costPenalty |
0.4 |
成本扣分权重 |
scoring.toolCallClass |
standard |
工具循环本身能换来的类别:standard(0.9.0)或 engineering(旧规则);其它取值一律回落到 standard |
hysteresis.downAfter |
2 |
降档前的安静步数 |
classifier |
rules |
rules 或 llm(每轮一次小调用,失败回落规则) |
classifierModel |
池中第一个 | LLM 分类使用的模型 |
classifierMinConfidence |
0 |
低于该置信度的 LLM 分类答案被忽略并回退关键词规则;没有 confidence 的旧式散文答案总是接受 |
imagePolicy |
keep |
vision 时带图任务路由到视觉模型 |
visionModel |
null |
显式视觉模型 id |
signals.todos |
true |
当前 todo 是否参与任务类型匹配 |
signals.contextPressure |
0.75 |
超过该占用比例偏向廉价档 |
signals.sessionTokens |
0 |
超过该 token 总量偏向廉价档 |
subagent.preferCheap |
true |
子 agent 是否优先廉价档 |
leaveImageSteps |
true |
带图步骤保持调用方模型 |
escalateOnErrors |
2 |
失败证据阈值 |
escalateOnRepeats |
3 |
重复调用阈值 |
maxEscalations |
2 |
单任务最多升几档 |
carryUnresolved |
true |
未解决的失败是否带一档到下一个任务 |
routes.<class>.effort |
low/low/high/high |
九词 effort 词表任选(v0.15.0);目标模型不支持时取最近档,等距向上;off 与 max 类词仍受两道闸门约束 |
安装
dsh plugin 是 pnpm 的前置封装,任何 pnpm 规格都能用。从 npm registry 装:
dsh plugin --profile web add @neptune810/dsh-model-router
或者直接从仓库装:
dsh plugin --profile web add github:Neptune810/dsh-model-router
装完需要重启 dsh web。路由器的监听器在启动时注册,刷新页面不够。
从 0.6.x / 0.13 升级:0.14.2 起内置路由表已把 trivial 送到 low,早年为抵消代码默认 trivial -> off 而在
profile 补丁里加的 routes.trivial.effort: low 可以删掉(重装插件会重写补丁层,这个 workaround 本来就是临时的)。
0.14.3 的 state.json 会在加载时自动升到 version 2 并保留旧会话记录。
运行要求与兼容性
- Node 20 或更新。
engines.dsh声明为>=0.1.7-rc.2 <0.2.0,在@deepseek-ai/dsh0.1.7-rc.2 上实测通过。 插件用到agent/request、agent/inbox/claimed、session.deriveMessages()与会话投影 (modelSelection、todos、contextPressure、tokenUsage)。- 不要在插件根声明
@deepseek-ai/*的peerDependencies。宿主启动闸门只读 peerDependencies, 解析不到时会把整个插件静默跳过,而不是报错;engines.dsh只用于 dshmarket 的安装兼容判断, 不参与启动。运行期防线是从 0.15 起的启动自检(缺契约时进入 degraded 并在面板说明)。 - 目前只验证过 web 平台的 composer 座位(
conversation.input.model);宿主未声明该座位时自动 回退到conversation.input.right的 chip。
已知限制
- 没有配置 schema。 配置直接读 profile 补丁层(见上),不会在设置界面渲染成表单。这是有意
为之:声明 schema 需要 import
@deepseek-ai/*包,而安装在 profile 旁的插件解析不到它们。 - 只处理
deepseek-officialprovider 与匹配familyPattern的模型。 - 输入栏控件靠注册接管官方模型格,而不是给组件打补丁。 它以优先级 -1 注册进
conversation.input.model(低于官方ModelSelect的 0),在自己的面板里保留官方「模型 + 推理等级」 两段。旧的conversation.input.rightchip(model-router:composer-control,order 20)会自我收回, 仅在宿主拒绝该座位时作为回退。0.10.0 的首次尝试现场表现为整格空白,0.10.1 已回滚,因为它没有在插件根 声明sessions/remote/remote.session。 - 每次调用的路由是紧跟在调用后面的一行独立小字,塞不进宿主自带的工具行,也塞不进思考链:keyed slot
会替换目标,而思考链没有子插槽。宿主还没折算出这次调用时它什么都不显示,而不是猜一个。插件源码改动
需要重启
dsh web才生效。
测试
node --test
421 个用例。test/policy.test.js(40 个)覆盖分类、无棘轮、max 不可达、拒绝 off、
证据升级、effort 钳制、中毒历史检测、tool-result 错误解析与 toolCallClass 开关(默认 standard、
engineering 恢复 0.9.0 之前的规则、其它取值一律取 standard);test/routing.test.js(26 个)覆盖模型池、
预设权重、视觉过滤、maxPerTask、effort 词表映射与迟滞,以及成本项(加权扣分与上限)、成本守卫的四种拒绝
(未定价条目、无底价、hard 豁免、倍数上限)、保证会话有路由的回退,以及渠道排序(被冷却的条目沉到健康条目之后、
渠道排名用来破平手、整池冷却时仍选最优);test/channels.test.js(18 个)覆盖按状态与按错误码的失败分类、滚动窗口与
成功率、TTFT 的 EWMA 与折减、连续第三次失败触发冷却、成功在两个方向上解除冷却、只停用不计失败的 bench、
orderChannels / channelRanks 的稳定顺序,以及指纹的四类拒绝;test/plugin.test.js(19 个)用 ctx/agent 替身
驱动宿主接线,包括安静的工具循环不再把档位抬到 high;test/modes.test.js(34 个)覆盖三种模式、手调让位与接管、同源校验、池/预设编辑、手动指定
任务类型、第三方 effort 词表、视觉分流、子 agent 廉价策略、todo 驱动任务类型、上下文压力、/router 命令、
LLM 语义分类,以及跨品牌守卫(先问会拦下并给出 proposal、允许/只切一次/禁止、只有异品牌时照常路由)与
定价路由;test/pricing.test.js(11 个)覆盖价格分类表、USD 分档边界、OpenRouter 解析与索引、手标条目
不被覆盖、快照优先于内置规则;test/effort-model.test.js(10 个)覆盖思考模式绑定唯一模型(没选不接管、绑定后清掉待选
标记、只调绑定模型的思考等级、词表取自它自己的池条目、无会话的绑定成为默认值)与按模式区分的手调让位
(思考模式下换模型不算手调、改思考等级才算,模型模式忽略改思考等级,模型+思考对两者都反应)以及新路由的
清空与校验;test/route-projection.test.js(12 个)覆盖投影契约(key/stateVersion、纯 JSON 状态、header
折算且「缺省」与「显式 null」等价、turn/step 跟踪、调用当时生效的 header、缺 header/step 时回落到调用自身的
值、重复 callId、按插入顺序丢最旧的 200 条上限、整数型 callId 的顺序、纯函数与 JSON 往返)以及宿主注册与
没有该服务时的加载;test/client.test.js(57 个)在 VM 里加载浏览器 bundle 并断言注册(路由行、作为回退且会自我收回的 composer chip、以及注册在 conversation.input.model 优先级 -1 上的合并座位)、
闭合的触发器、文档里的同源路由、路由 Definition 的匹配与锚点、路由行
防御式读取投影、本地化默认标签、座位面委托给会话目录、官方选择语义(模型行不带 reasoningEffort、思考行
带它、供应商默认行、点当前行是空操作、会话锁定、子 agent 会话不可用、选择失败保留错误、目录出错可重试、
分组顺序)、插件半边原来的控件/池/设置载荷与 /effort-model 绑定,目录黄点与它下面的最多三行说明(宿主不发 catalog 块时完全安静)、成本影子的那一行(分叉时带节省比例、一致时的
写法、开关状态、英文界面,以及宿主不发 costAware 块时的安静)、预算闸门(临近上限的圆点与用量条、超支时长度
夹到 100%、token 行、限制为 0 与畸形块都保持安静)、inform 与 shift 下的峰谷提示(关闭或非高峰时安静)、
中英双语的渠道冷却/隔离行、档位映射那一行(别名、就近取档、模型不接档位、原样落地与畸形块都安静、英文界面),以及声明的 ui-chat 座位与
uiConversation 服务;test/store.test.js(6 个)覆盖状态文件恢复(损坏文件先备份、v1 版本迁移、写失败经 storeHealth 暴露、会话表按最久未出现淘汰);test/routes.test.js(10 个)覆盖面板 token、同源读校验、路径脱敏、ETag/304 与 /stats 透传;test/release.test.js(8 个)覆盖发布门禁(tag/版本/CHANGELOG 一致性与 tarball 内容);test/catalog.test.js(21 个)按 schema 校验随包模型目录、钉住已知告警清单、证明生成器可复现、校验 watchlist 规则并覆盖 findModel;test/catalog-pricing.test.js(18 个)覆盖当时生效的价格(pricing.next 到生效日切换、峰谷时段)、token 拆分、「未知即 null 不是 0」与提醒窗口;test/catalog-diff.test.js(15 个)用冻结的 OpenRouter 快照驱动漂移报告;test/smoke.test.js(11 个)用假宿主驱动 scripts/smoke.mjs 并校验 PASS/WARN/SKIP/FAIL 四种退出状态;test/telemetry.test.js(15 个)覆盖决策事件的落盘、按月分文件与 8 MB 轮转、flush、坏行容忍、聚合形状、token/美元账本(旧事件计为未定价)、成本影子账本(畸形的影子被跳过,无定价对的那一步计数但不计钱)、只报一次的错误、关闭开关与档位映射计数;test/observation.test.js(23 个)端到端串起 /state 观测面、ETag 304、/stats 聚合、/router replay、LLM 分类置信度过滤、九词路由守卫与 scoreParts 分项,以及成本影子(成本感知会选谁、实盘已经很便宜时记为一致、打开开关后路由真的跟着变、目录无法定价的池既不记单价也不记影子),以及 0.16.1 的观测面:预算闸门拒绝合成步骤并
放行一次、inform 模式只警告不拦、被停用的渠道让重试换到另一供应商、关闭故障转移时路由保持不动,以及跨品牌
提案只在明显更好或更便宜时出现;test/pricing2.test.js(15 个)覆盖混合单价(高峰、空闲与周末、纯缓存读与纯输出构成)、长上下文档(阈值最大者优先、effectiveFrom 生效、whole_request 与 excess)、stepCost 在三个时刻与目录价格逐位相同、以及千次调用行在生效日前后;test/feedback.test.js(8 个)覆盖三个标签及其别名、归一化记录(备注折叠、长度上限、缺省 provider)、结果对、跳过坏行的读取器、聚合(按标签、按任务类型、覆盖占比、被回答的结果),以及关闭时不写任何东西;test/classifier2.test.js(6 个)覆盖散文里的结构化结论、置信度闸门、「上调一档而不是猜」、有界重试与连续三次失败打开的熔断器;test/experiments.test.js(7 个)覆盖哪些任务类型可探索、种子抽签、每一种拒绝理由、exploit 与 explore、epsilon 夹取与按臂报告;test/effort.test.js(7 个)覆盖八档阶梯与分值、未知词按 high 归类、预算表与按模型覆盖、maxOutput 夹取、四种 why、按类型/组合的汇总与畸形输入;test/replay.test.js(5 个)用冻结账本驱动 lib/replay.js(原样回放、今天会换路由的一步、--fail-on-change、暴露别名塌缩的配置、--since/--until 窗口、两条 exit 2 路径);test/golden.test.js(11 个)冻结十个代表性场景的路由结果(GOLDEN_UPDATE=1 才重写),任何非预期漂移都会失败。
test/contract.test.js(7 个)把 1.0 契约本身钉住:每个应答都带 schemaVersion(连拒绝应答也算)、docs/api.md 里的路由与注册的路由完全一致、插件监听的每个宿主事件都出现在 docs/compat.md、每个导出都能解析且落在发布目录内、包声明了它支持的宿主且从不 peer 依赖宿主、1.0 的文档集齐全、面板点名的降级都有文档对应。
模型目录
路由的策略是代码,模型的事实是数据。catalog/model-catalog.yaml 是唯一事实来源:每个可寻址模型多少钱、
接受哪些思考等级词、上下文窗口多大、由哪些渠道承载、接下来会有什么变化——19 个模型,每个都带证据日期,
宁可写 unknown 也不猜。它按 schema/model-catalog.schema.json 校验,再由
scripts/build-catalog.py 生成 lib/catalog.js;生成物入库,不手改。
py -3 scripts/build-catalog.py          # 从 YAML 重新生成 lib/catalog.js
py -3 scripts/build-catalog.py --check  # 两者不一致就失败
node scripts/check-catalog.mjs          # 结构校验,不需要 Python
0.15.1 起路由器确实读它,但只用来算钱和算日期:每条决策按该步当时生效的价格计价(lib/catalog-pricing.js),
/state.catalog 报告近期硬日期。路由本身仍按池内相对 cost 打分,不看目录价格——0.16 才让价格进入分数。
发布检查
每次发布在本地和 CI 走同一道门禁:
npm test                                # 全部测试
npm run release:gate                    # tag = package.json = CHANGELOG,以及 tarball 内容
py -3 scripts/build-catalog.py --check
scripts/check-release.mjs 会拒绝缺文件或误打包测试源码的 tarball,也是从此版本号、CHANGELOG 标题和
推上去的 tag 不能再各走各的原因。CI 在 Node 20、22、24 上跑测试;打 tag 的那次用 npm trusted publishing
发布并附带 provenance。完整检查单与回滚步骤见 PUBLISHING.md。
许可证
MIT