sage-mem
Đã xác minhsage-mem · v0.9.12 · Apache-2.0 · Giao diện web
File-based memory plugin for DeepSeek Harness (DSH) — cross-session memory in plain markdown files, with a memory star-map view, type/tag filtering, retrieval aliases, and an optional autodream pass that consolidates memories on demand or on a schedule —
Cài đặt
dsh plugin add sage-mem Xác nhận layer đã áp bằng dsh --profile default --dump-config — xem hướng dẫn cài plugin.
Mã nguồn
Thẻ
Readme
sage-mem · DSH 的文件式记忆插件


给 DeepSeek Harness(DSH)装上跨会话记忆。纯 Markdown 存储,透明、可检查。
如果这个工具帮到了你,欢迎给个 ⭐️ Star 支持一下!
记忆就是本地的一堆 Markdown 文件(frontmatter + 正文)——不是数据库,没有私有格式。agent 今天记住的事,明天的新会话自动想起来。
English — file-based cross-session memory for DeepSeek Harness: every memory is a plain markdown file you can open, edit and delete; no database, no worker, no port.
为什么需要 sage-mem
DSH 原生没有记忆系统。每个新会话都是一张白纸——agent 不记得你是谁,不记得你们昨天做到哪,不记得项目进行到哪一步。你只能每次重新交代一遍。
市面上的记忆方案大多走 SQLite + 常驻 worker:记忆写进数据库就不透明(想看看存了什么得去查表),事件全捕获又会让库膨胀(「用户打了个招呼」也算一条),还得额外养一个进程和一个端口。
sage-mem 换一条路:每条记忆就是一个 Markdown 文件。用编辑器打开就能看、能改、能删;存不存由 agent 按规则判断,不做无差别捕获。让 agent 真正记住你和你的项目,而这份记忆始终握在你自己手里。
核心特性
| 特性 | 说明 |
|---|---|
| 文件式存储 | 每条记忆一个 .md:frontmatter 存元数据,正文存内容。无数据库、无隐藏格式,VS Code 直接打开就能改 |
| 跨会话记忆 | 每轮提问自动扫记忆目录、按相关度挑出最相关的几条注入上下文。agent 第一轮就「想起来」,不需要它自己去翻文件 |
| Claude Code 无损迁移 | CC 的记忆与人格都是 Markdown——直接拷文件就完成迁移,不写转换脚本。详见下一节 |
| 零额外服务 | 无 worker、无 SQLite、无端口、无常驻进程,不需要额外的 API key 或云服务(运行时唯一的依赖是普通 npm 库 zod) |
| 防膨胀 | 靠规则引导 agent 判断「值不值得存」:无实质内容的不存,靠读代码 / git 能推出来的不存 |
界面上还有三块附加能力(都可以不用):
- 记忆管理页(v0.4)——DSH 设置页里的「记忆管理」:浏览、查看、编辑、删除、新建记忆,不用离开 GUI
- 类型与标签筛选(v0.6)——文件列表顶部一排 chip,按四类 + 自定义标签筛;标签从全库自动聚合计数,与搜索框是 AND 关系
- 记忆星图(v0.4 起,v0.6 重做)——把记忆画成星空:按类型着色、按体积分级、按新鲜度分亮度,还支持时间线与「诞生回放」。渲染是按需重绘,画面静止时不发起任何绘制
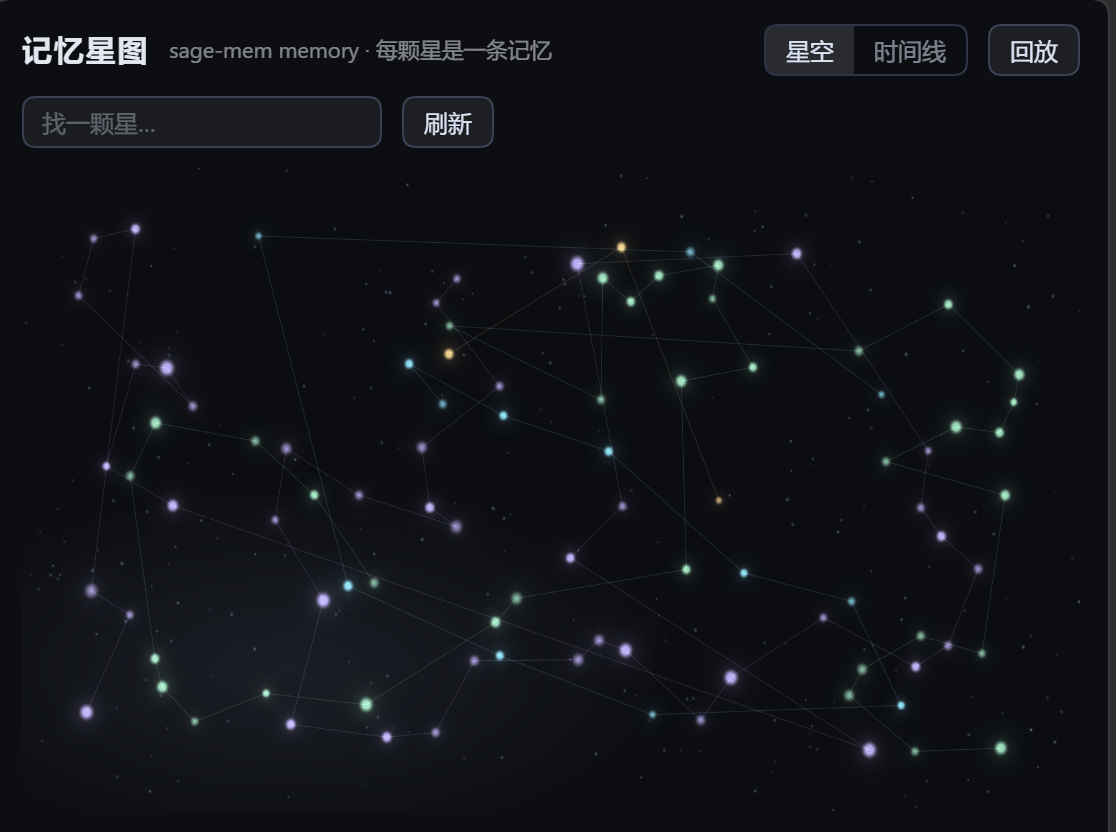
记忆星图:每颗星是一条记忆 —— 颜色对应类型、大小对应体积、亮度对应新鲜度,底部是四类计数与库总体积。画布上只画关系与分布;悬停或点开某颗星时才会显示那一条的文件名。
界面预览
下面每张图都是从仓库里的界面代码渲染出来的(同一份 CSS、同一棵组件树,数据是演示用的假数据,不是真实记忆目录)。
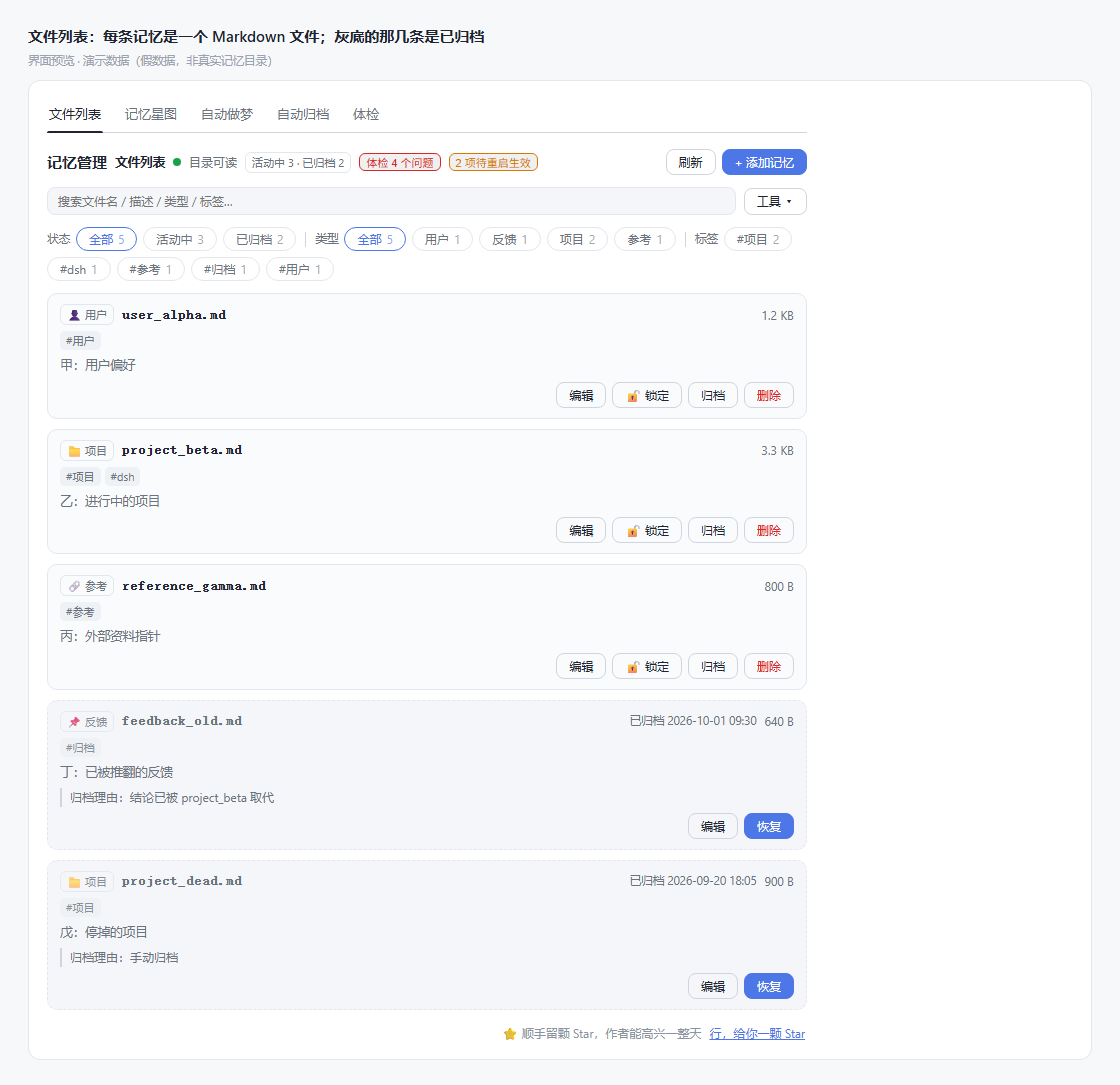
文件列表 —— 头部带常显「体检 N 个问题」与「待重启生效」,不用点开就知道该不该处理;灰底条目是已归档,随时可以恢复。
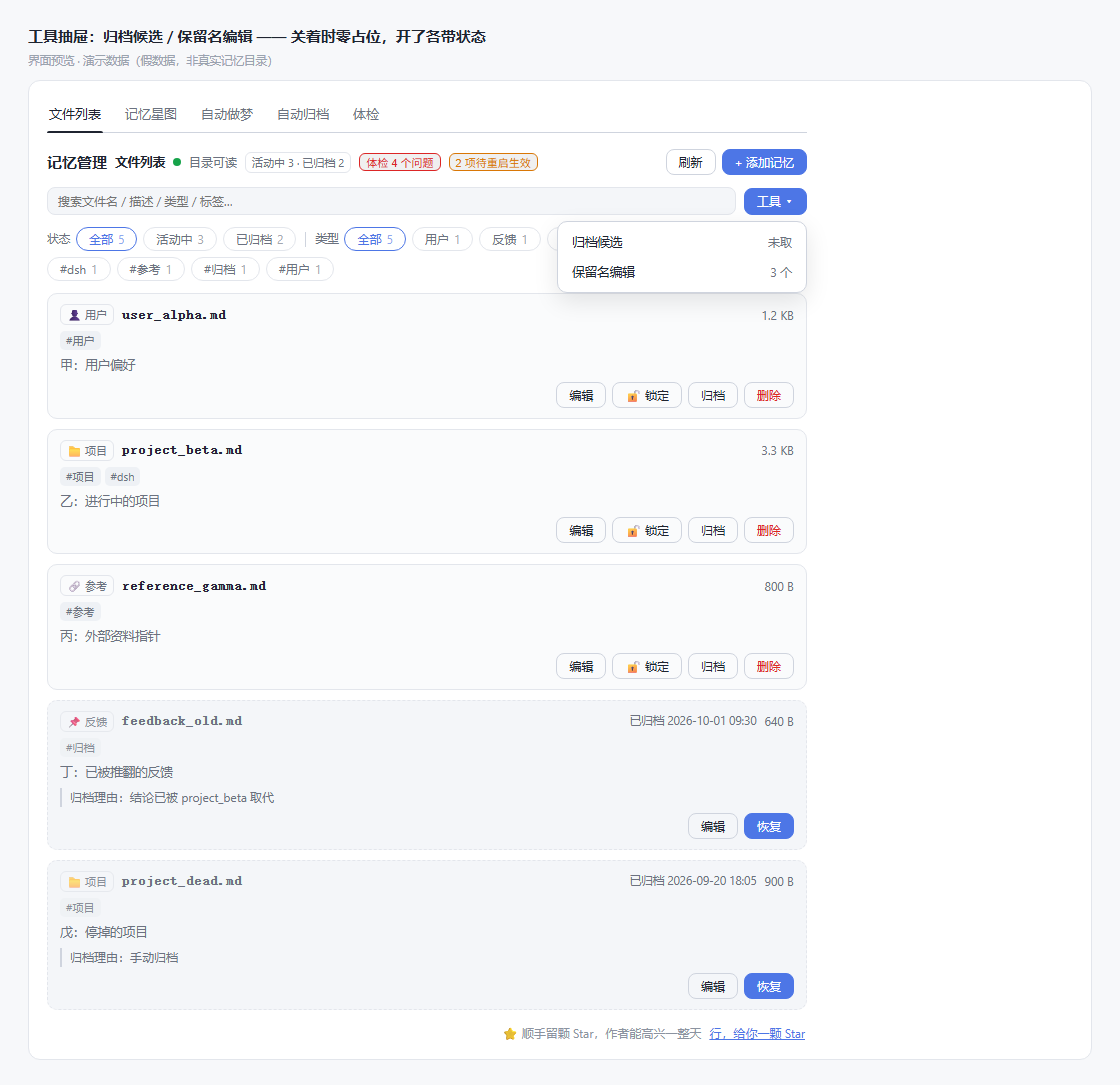
工具抽屉 —— 关着时只占一个按钮,展开后两项各带状态:归档候选 2 条 / 保留名 3 个。(体检不在这里:它自己有一页。)
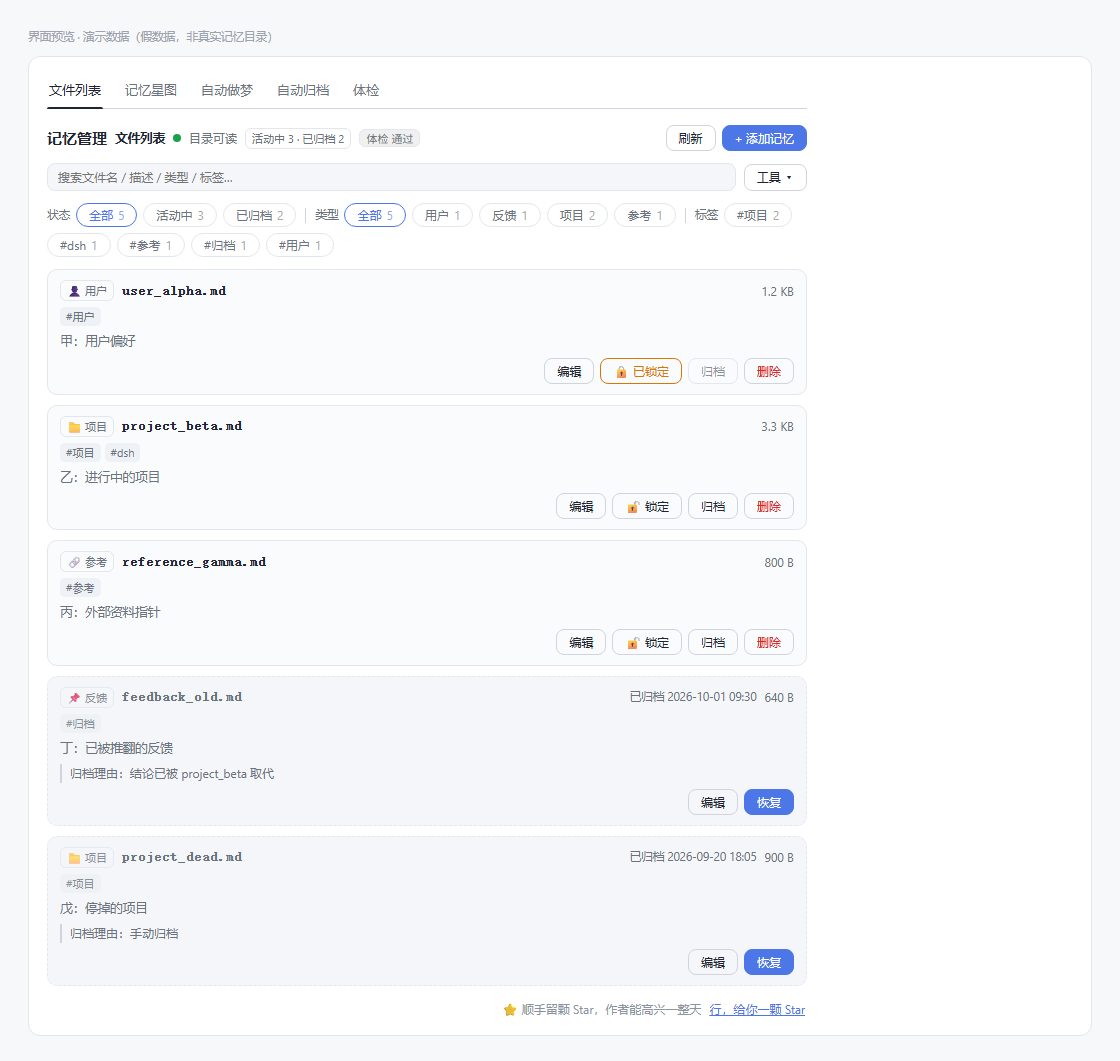
锁定 —— 重要记忆(人设、偏好这类)点一下就锁上:自动归档的候选里不再出现它,手动点归档也会被宿主拒绝。锁存在状态目录里,不写进记忆自己的 frontmatter —— 那会被自动整理重写掉,锁一丢它又会回到候选里。
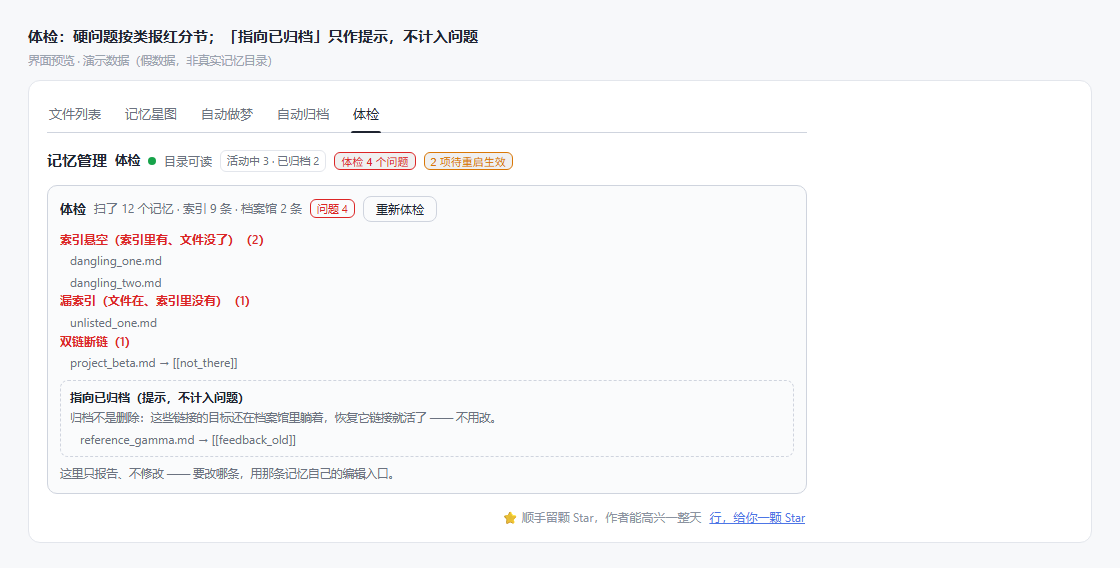
体检(独立成一个页签)—— 索引悬空、漏索引、断链这类硬问题按类报红;「指向已归档」只作提示、不计入问题,也不提供一键修补按钮(改哪条由你决定)。从档案馆恢复一条记忆时,插件会顺手把它补回索引 —— 以前只搬文件、不补条目,于是顶层有文件、MEMORY.md 里没有,体检一直报「漏索引」。
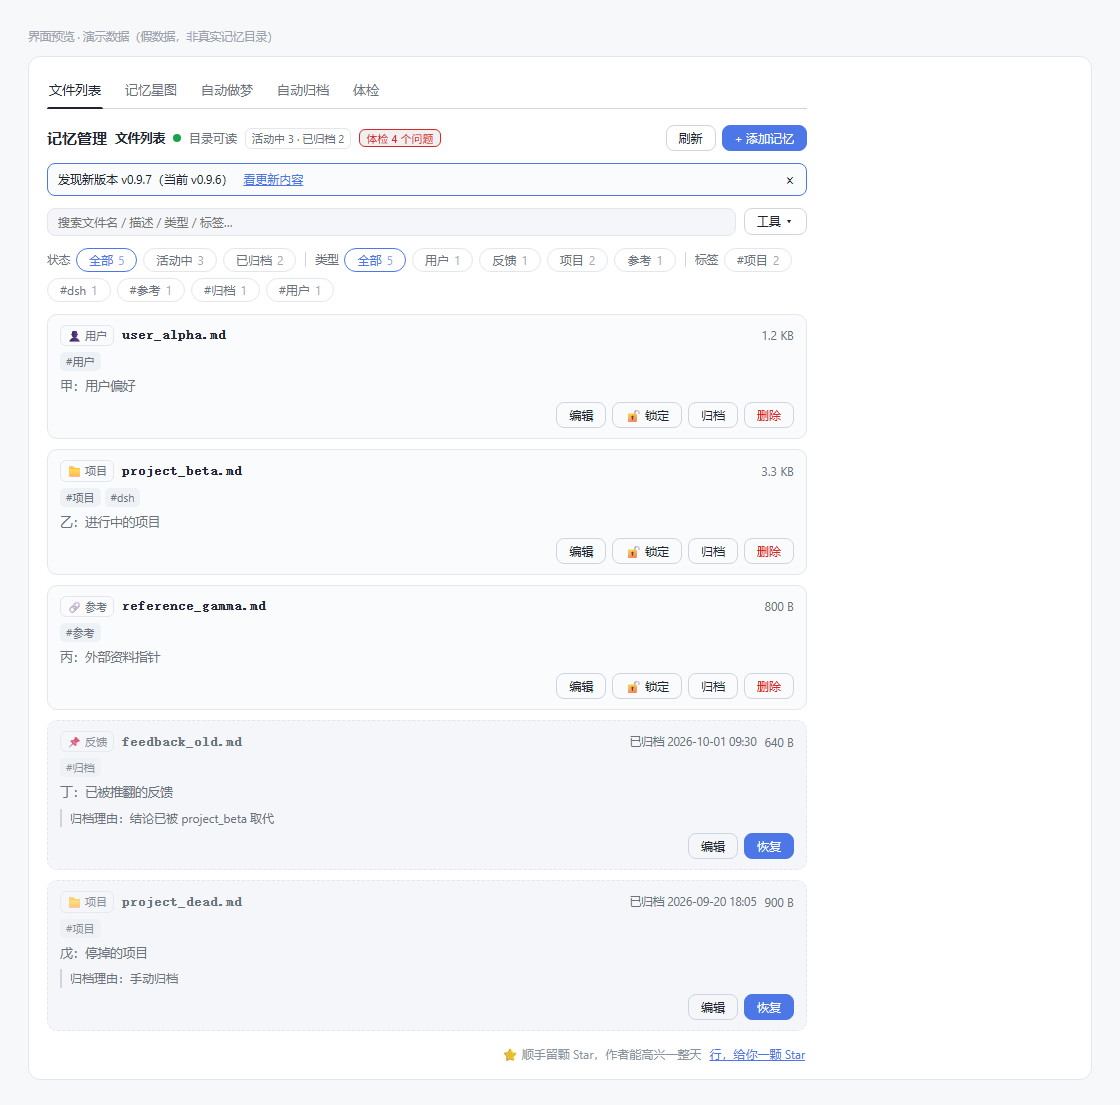
更新提示 —— 只在真有新版本时出现一条横幅,写明新版本与当前版本;「看更新内容」开新标签页,「×」只是这次不看。查不到 / 被限流 / 网络不通一律静默,不会因为查版本失败而冒红条。
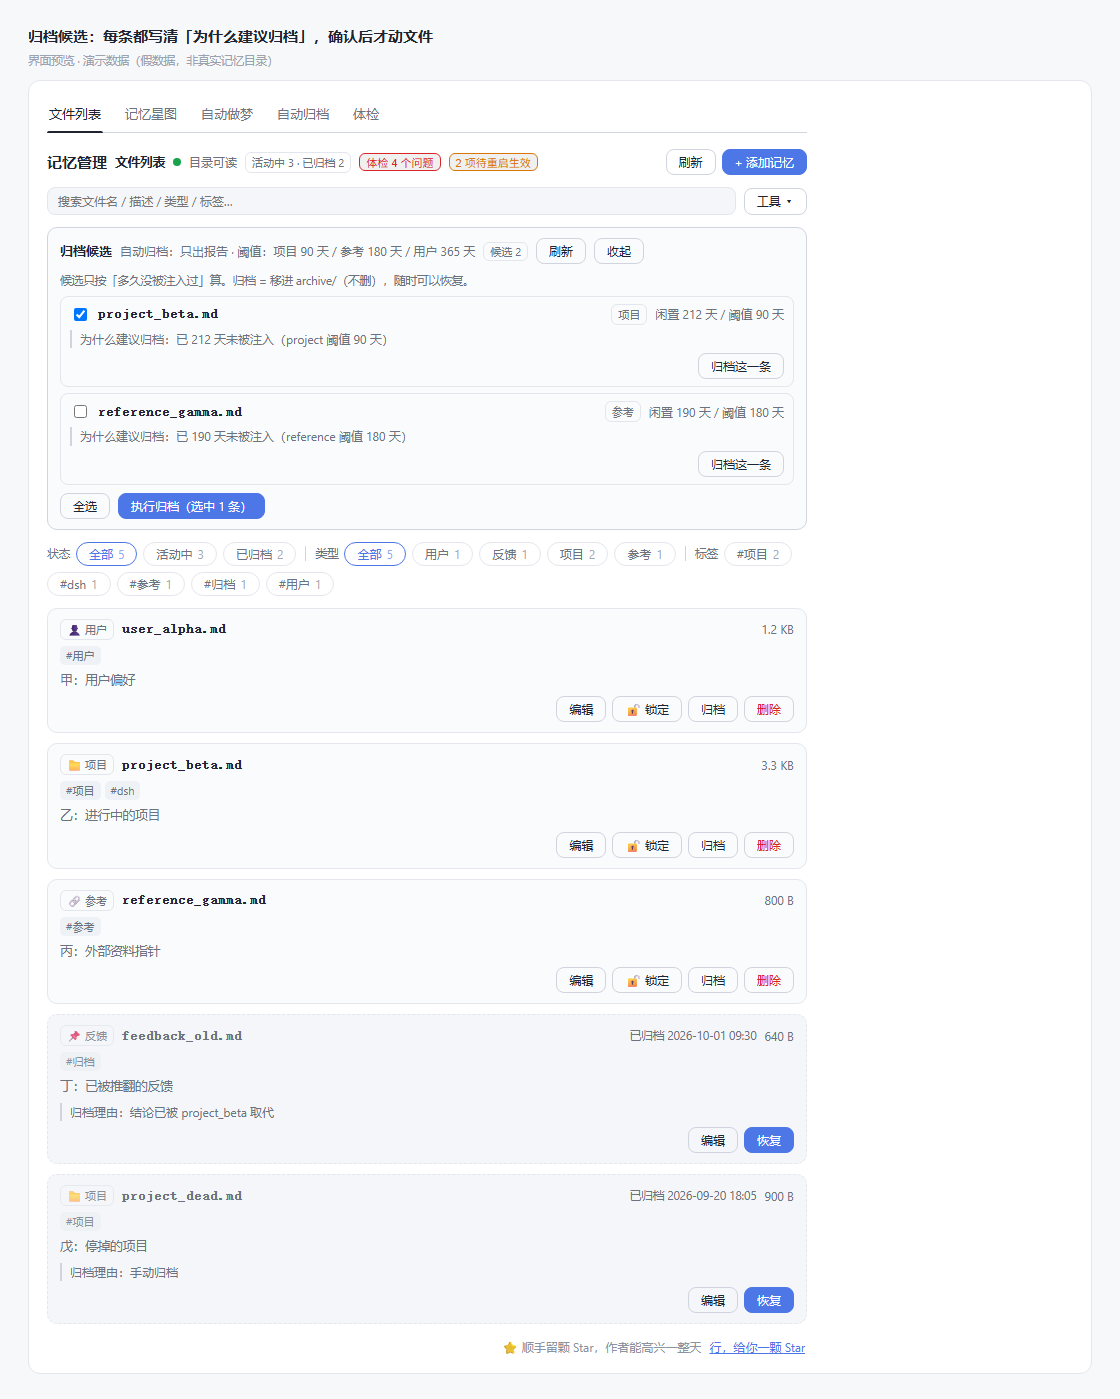
归档候选 —— 每条都写清「为什么建议归档」(闲置天数 vs 该类型阈值),逐条或全选后确认才动文件;归档是把文件移进 archive/,不删除。
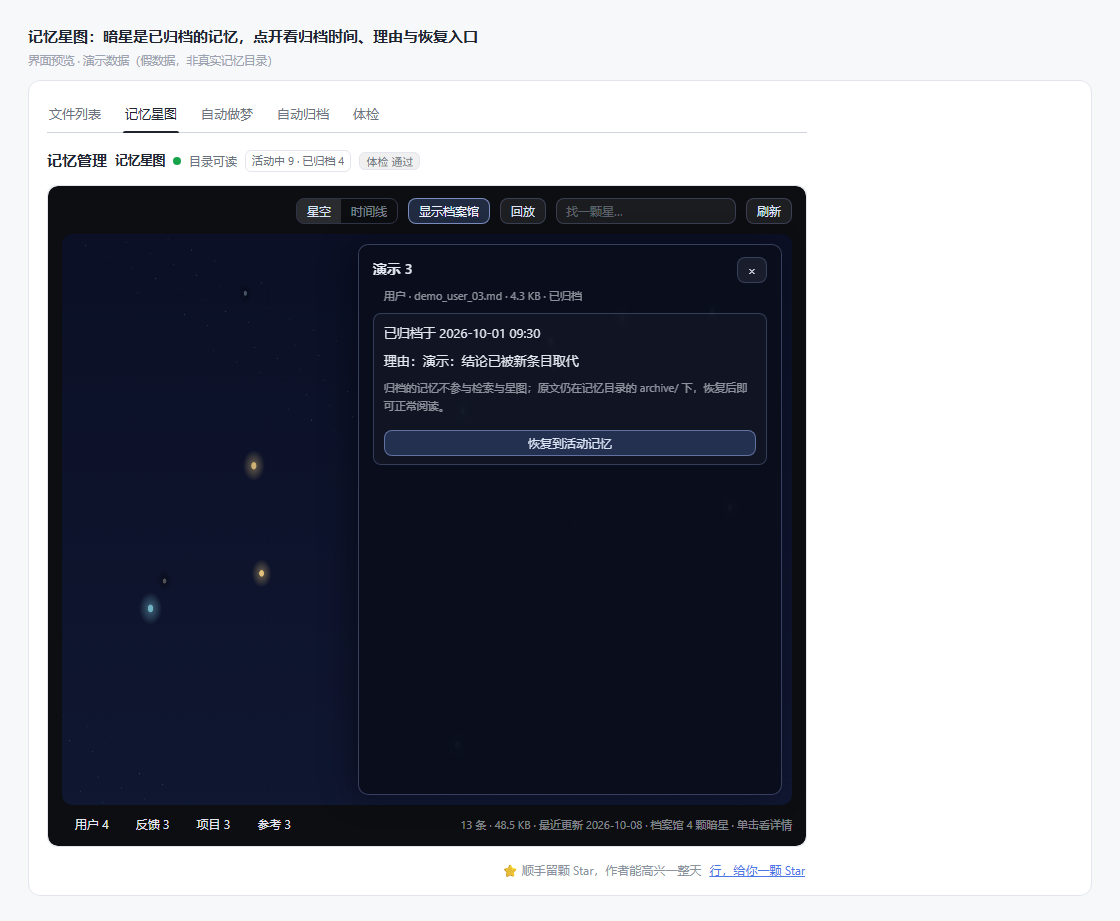
记忆星图 —— 暗星是已归档的记忆;点开看归档时间、理由与「恢复到活动记忆」。
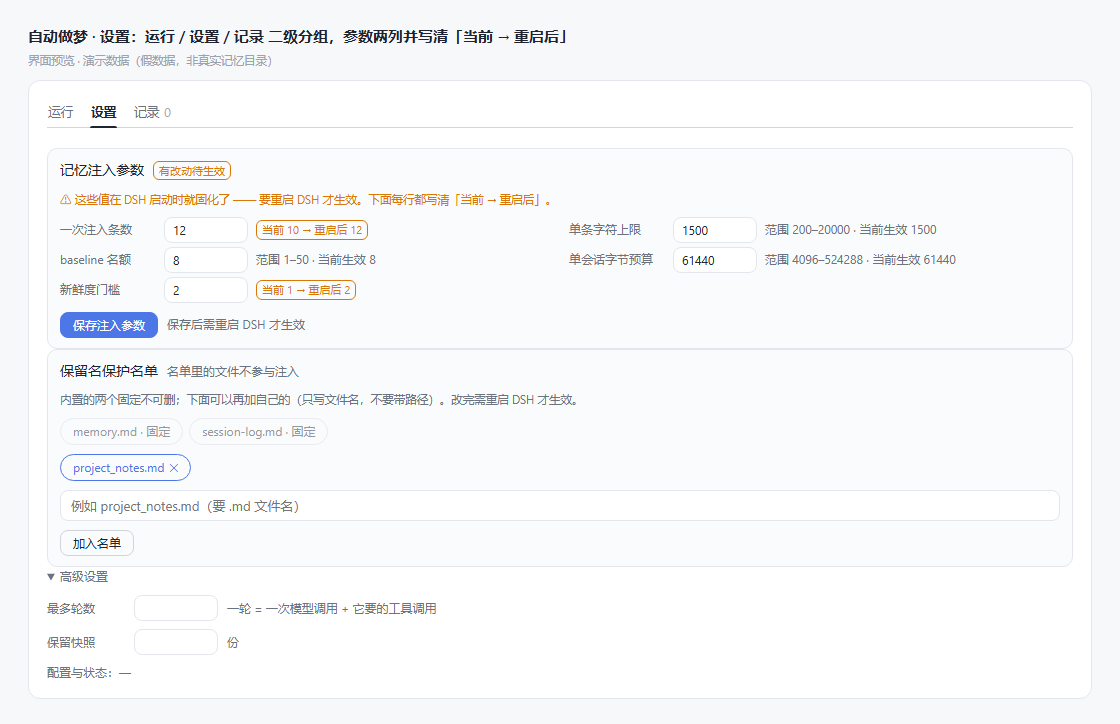
自动做梦 · 设置 —— 运行 / 设置 / 记录 二级分组;五个注入参数两列排开,并写清「当前生效」与「重启后」,不会让人误以为改完立刻生效。
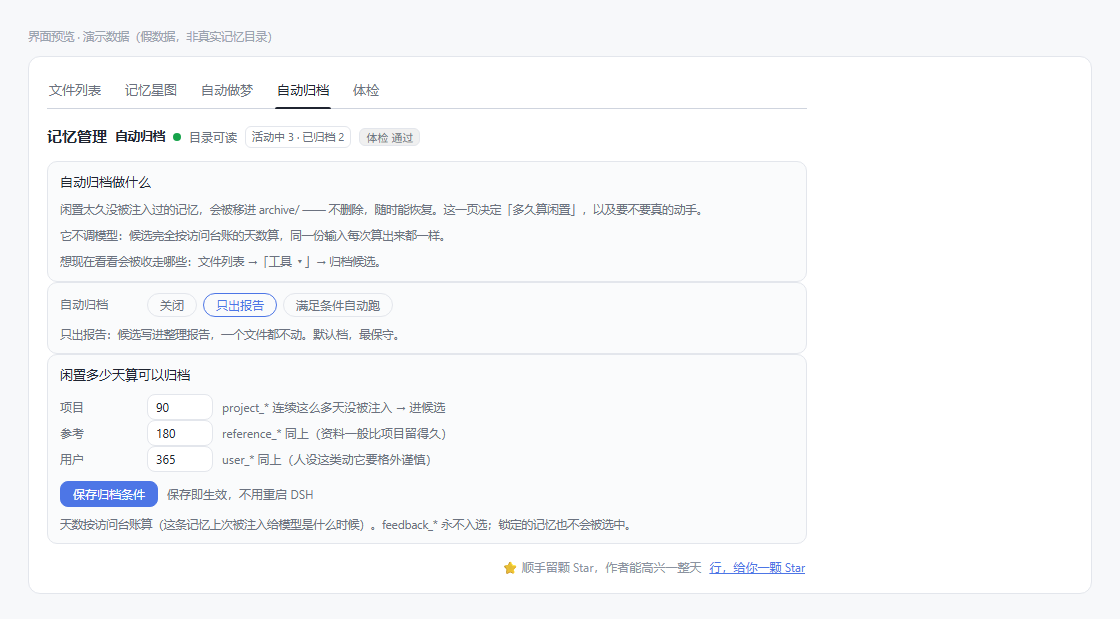
自动归档(独立成一个页签,排在「自动做梦」与「体检」之间)—— 它和自动做梦不是一件事:归档是*确定性规则(按访问台账的闲置天数算,不调模型),混在模型那套设置里既难找、也容易让人以为归档会花钱。这一页决定「多久算闲置」,以及要不要真的动手;阈值保存即生效,不用重启。*
快速开始
需要 DSH 0.1.2-rc.1 或更高(见兼容性),Node.js >= 18。
# 把 web 换成你自己的 profile 名
dsh plugin --profile web add sage-mem
dsh plugin add 一步做两件事:把 sage-mem 装进这个 profile 的依赖,并自动把它的 bundle 追加进 dsh.profile.bundles——不用手改 package.json。
装完重启 DSH。确认装上了:
dsh plugin --profile web list
然后开一个新会话试一句:
- 跟 agent 说「记住:我的猫叫芝麻,它喜欢晒太阳」——它按规则把这条写进记忆目录
- 再开一个新会话,问「我的猫叫什么」
- 第一轮就该答出「芝麻」——记忆由插件自动检索并注入,agent 没有主动去翻
手动安装(不想用 CLI,或要装本地开发版本)
在 profile 的 package.json 里加依赖,并把包名写进 dsh.profile.bundles:
{
  "dependencies": {
    "sage-mem": "^0.7.0"
  },
  "dsh": {
    "profile": {
      "bundles": ["sage-mem"]
    }
  }
}
本地开发用 clone 出来的源码:
{
  "dependencies": {
    "sage-mem": "link:../sage-mem"
  }
}
改完跑 pnpm install,再重启 DSH。
记忆目录
默认在 ~/.sage-mem/memory。想放到别处(比如放进项目仓库、跟着 git 走)就设环境变量:
SAGE_MEM_DIR=/path/to/your/memory
从 Claude Code 无损迁移
你已经在 Claude Code(CC)里养了一个 agent,舍不得它的记忆和人格?sage-mem 是「CC → DSH」迁移方案的一部分,两样都能无损搬过来:
| 搬什么 | 从 | 到 | 怎么搬 |
|---|---|---|---|
| 人格 | CC 的 CLAUDE.md |
DSH 的 AGENTS.md |
DSH 原生加载,纯文本,一字不改就能用 |
| 记忆 | CC 沉淀的跨会话记忆 | sage-mem 的 memory/ 目录 |
markdown + frontmatter 四类,拷进去即可 |
没有数据库、没有私有格式——全都是 Markdown 文本,直接拷文件就完成迁移。agent 换了身体,但依然记得你是谁、记得你们聊过什么、记得进行中的项目。
检索是怎么工作的
透明的东西值得说清楚它怎么选料,因为它直接决定注入多少 token:
- 信号是
description,不是全文。每条记忆的description(「一句话说清这条是什么」)、文件名、以及可选的aliases(别称)一起参与打分,最多注入 10 条相关记忆。旧版拿问题里的双字去全文里蒙,长记忆天生占便宜——实测长记忆在全文匹配下连寒暄问句都能注入上千 token;改用description后噪音大幅下降 - 换个说法也能命中:打分是词面重合(双字组覆盖率),不是语义的——问「我有什么待办」而文件里写的是「代办清单」,差一个字就完全不命中。给这类记忆加一行
aliases: [待办, todo]就能补上 - 正文超 1500 字符就截断并标
…(截断),单条记忆不会吃掉整个上下文 - 同一个问题不会重复注入(按会话记签名),问第二遍不会又追加一遍
- 单场会话累计注入到 60 KB 就停(
MAX_SESSION_BYTES)。条数上限管的是「一次注多少」,这条管「一场会话总共注多少」—— 长会话里问题一直在换、签名一直在变,累积本来没有上限。到顶之后新的记忆不再注入(这时该让 agent 直接读文件),压缩或清空之后账面自动归零,又能注进来 - 每条记忆的标题带新鲜度:
(保存于 N 天前),优先读 frontmatter 的updated:,缺失才回落文件 mtime —— 手写的时间戳是权威,文件系统时间会被复制 / 备份还原 / checkout 整批改掉。理由是陈旧记忆被当事实引用时,「引用」这个动作本身会让它显得更权威而不是更可疑,所以注入文本开头还带一节引用纪律(提到路径先确认存在、提到函数先 grep、要动手先核实)。它独立成节而不是一条 bullet:Claude Code 实测同一句话埋成 bullet 命中 0/3、独立成节 3/3 baseline: true的记忆每场会话第一步无条件注入,最多 8 条——给「你是谁」「待办清单」这类每次开场都该在场的记忆用。多条 baseline 之间的先后由baselinePriority决定(数字越大越前,缺省 0),不按文件名排- 记忆目录读不到、权限错、frontmatter 格式坏,这些都降级为不注入并写日志,不会静默失效
单文件上限 512 KB,读写两侧都校验(读的时候先看体积,超了就不读进来);标签最多 20 个、每个 40 字符(再多就不是标签,是一句话被塞进 tags 了)。
自动做梦(autodream)
可选的记忆整理功能:把记忆目录通读一遍——合并重复的、删掉被推翻的、修索引与断链、把相对日期换成绝对日期,让下一次会话能快速对上位置。
默认关闭,在设置页「记忆管理 → 自动做梦」里开。三件事各自可选:
| 选项 | 取值 | 说明 |
|---|---|---|
| 触发 | 只手动 / 满足条件自动跑 | 自动模式走三级门控,最便宜的先查:时间门(距上次 ≥ N 小时,一次读写)→ 会话门(期间 ≥ M 个会话有更新,一次目录扫描)→ 锁(防并发)。中间夹一层 10 分钟扫描节流,免得「时间门过了、会话门没过」时每轮白扫 |
| 改动方式 | 只出报告 / 直接改写 | 「只出报告」模式下写工具根本不会挂给模型——不是靠一句「请不要写」约束,是它没有手 |
| 输入源 | 仅记忆目录 / 记忆 + 会话记录 | 后者会解压会话记录(zstd)做定向关键词搜索;代价是私密对话会进入模型上下文,token 成本也更高 |
整理用的模型可以单独指定
整理是后台批量任务,跟聊天用的不一定是同一个模型。设置页「高级设置 → 模型」可以从当前已配置的模型路线里挑一条(选项与「模型选择」里的目录同源,也带每条的显示名);第一项是跟随当前会话默认模型。
- 选了就只认它:路线在宿主里不存在时,开工前就报错(运行前的纯本地存在性校验,只比对宿主已注册的目录、不发任何请求),不会跑到一半才失败,也不会静默回落到默认模型。
- 面板下方始终显示实际生效的是哪条(配置指定 / 跟随默认),配置里那条路线万一从目录里消失了,下拉框也会把它显示出来而不是悄悄跳回默认。
- 拿不到模型目录时(宿主差异),退化成手填
provider与model。
回滚点
只要这次是「直接改写」,开工前就先建一个回滚点(整个记忆目录顶层 .md 全量快照,每条带 sha256),跑完之后你能在设置页看到它、也能一键退回去。
- 回滚点与这次运行绑定:报告里写着 runId,回滚点目录同名,两边对得上。
- 回滚本身也能退:动手之前会先把「现在」再存一份保护快照(它不参与普通快照的轮转淘汰)。
- 范围可选:只恢复这次运行动过的文件,或整目录回到该时点。
- 全程不删文件:回滚中「不该存在」的文件一律移进
archive/,人工可捞回。有同名冲突就跳过并计数,绝不覆盖。 - 每次回滚都留痕:报告目录里写一份回滚报告,
.sage-mem/autodream/rollbacks.json里追加一条记录。
整理声明:改了什么、为什么
每一次整理都留下一份声明,两种形态:人读的 memory/autodream/<runId>.md(报告里内嵌),机读的 .sage-mem/autodream/runs/<runId>/manifest.json。
- 逐条记录:文件 / 操作(新建·改写·归档)/ 缘由 / 字节变化,外加运行前后的结构审计对比。
reason应当填写。write_memory不带reason不会被拒绝——改动照样生效,但整理声明里会把它标成「未自述」并附上宿主能追溯到的信息(第几轮 / 什么操作 / 字节变化)。archive_memory的reason仍必填,缺了直接拒绝;被拒的动作单列一节「未能落地的改动」,不会静默消失。(不硬拒write_memory是有意的:为了一句解释而丢掉一次本来正确的修正,代价更大。)- 面板的「整理记录」区列出每一趟(时间 / 模式 / 改了几条 / 是否已被回滚),点开看声明全文。
三道安全网
- 安全边界在工具集上,不在提示词里——自动做梦时宿主只把
list_memory/read_memory/audit_memory交给模型,改写模式才多给write_memory/archive_memory;输入源选「记忆 + 会话记录」时另加search_sessions。而且没有「删除」这个能力:归档是把文件移进archive/,可以人工捞回 - 改写前自动建回滚点(只快照顶层
.md,不含archive/),落在<memory 目录的上一层>/.sage-mem/autodream/snapshots/<runId>/,保留最近 N 份。理由是记忆目录不在任何版本控制下、删除没有回收站,「可回滚」得自己造 - 跑完自动审计:七查(索引悬空 / 漏索引 /
type与文件名前缀不一致 / CRLF / 双链断链 / frontmatter 里被 YAML 当注释吞掉的「空格 + #」/ 无 frontmatter),外加「读不动」单列一类,结果与前后对比写进报告。它只报不改
最多轮数、回滚点保留份数在「高级设置」里;回滚的默认范围在「回滚点」区里选。
报告落在 memory/autodream/<runId>.md——子目录,不会被扫成记忆条目。
关于自动触发:整理沿用插件自己的定时器(
ctx.timer,默认 30 分钟查一次门控),没有接进设置页那个「自动化任务」面板。原因是两者的触发模型对不上——那个面板的语义是「到点唤醒一个会话、让它跑一轮对话」,而自动做梦刻意不走会话(工具集由插件给、步数有上限、不污染会话记录),两者的触发模型对不上。硬接的代价远大于收益,所以不做。
改名说明(0.7.0)
本功能原名「做梦」(标识 dream),0.7.0 起叫 自动做梦(autodream)。旧数据不会被丢:老的配置 .sage-mem/dream.json 会被读出来并迁移到 .sage-mem/autodream.json(旧文件保留不动),老报告 memory/dream/ 仍在面板里列出并标「旧版」,老快照 .sage-mem/snapshots/ 也仍可回滚。
记忆文件格式
---
name: 可选的短名
description: 一句话说清这条记忆是什么(检索靠它,务必写准)
metadata:
  type: user        # user / feedback / project / reference
tags: [项目, 待办]   # 可选,供列表页筛选
aliases: [待办, todo] # 可选:换一种说法也能被检索到
baseline: true      # 可选:新会话第一步无条件注入(上限 8 条)
baselinePriority: 10 # 可选:多条 baseline 之间谁先注入(越大越前)
---

记忆正文。
四类记忆:
| 类型 | 存什么 |
|---|---|
user |
用户是谁 |
feedback |
工作方式指导(建议带 **Why:** 与 **How to apply:** 两行,方便判断边界) |
project |
进行中的工作与状态 |
reference |
外部信息在哪找的指针 |
架构
DSH(Cordis 插件)
  └─ sage-mem 插件(按问题检索 + 注入)← 本仓库
       │  Node fs 直读
       ▼
memory/ 目录(markdown 文件,4 类)
  ├── user_*.md
  ├── feedback_*.md
  ├── project_*.md
  ├── reference_*.md
  └── MEMORY.md          ← 索引
没有 worker、没有 SQLite、没有 HTTP 端口、没有常驻进程。
权限与数据
sage-mem 只做三件事,全都在你本机:
| 它做什么 | 具体范围 |
|---|---|
| 读记忆 | 只读 SAGE_MEM_DIR(默认 ~/.sage-mem/memory)下的顶层 *.md,单文件上限 512 KB(读写两侧都查) |
| 写记忆 | 经 agent 的文件工具或设置页写同一个目录;MEMORY.md、session-log.md 等保留名受保护,设置页碰不到 |
| 注入 | 把选中的记忆作为上下文交给模型(最多 10 条相关 + 8 条 baseline,单场会话累计上限 60 KB) |
它不做什么:不联网、不开端口、不起常驻进程、不需要任何 API key;默认只读写记忆目录与它上一层的 .sage-mem/ 状态目录(配置、回滚点、报告)。例外:输入源选「记忆 + 会话记录」时,它会额外读 $DSH_HOME/sessions 下的会话记录做定向搜索——那会解压你的对话原文(含私密内容)并送进模型上下文,所以默认不开,见「自动做梦」一节;
不做事件全捕获(存不存由 agent 按规则判断,不是"你说了什么都记")。
记忆就是那个目录里的文件,随时可以打开确认——这也是选文件式的原因。
(唯一会调用模型的功能是「自动做梦」,默认关闭。它的模型默认跟随当前会话默认模型,也可以在设置页单独指定一条——指定了就只认它,不会静默回落。)
DSH 兼容性
sage-mem 是纯 DSH 插件,用 package.json 的 engines.dsh 声明宿主要求:>=0.1.2-rc.1 —— 单边开区间、不设上界,所以任何未来的 DSH 版本都不会被这道声明挡住。逐版本核对记录如下:
| DSH 版本 | 状态 |
|---|---|
| 0.1.2-rc.1 | compatible |
| 0.1.3-alpha.1 | compatible |
| 0.1.3-alpha.2 | compatible |
| 0.1.5-rc.1 | compatible |
| 0.1.6-alpha.1 | compatible |
| 0.1.6-alpha.2 | compatible |
| 0.1.7-rc.1 | compatible |
| 0.1.7-rc.2 | compatible |
| 0.2.0-rc.1 | compatible |
| 0.2.0-rc.2 | compatible |
两点值得说明:
- 同一份构建同时覆盖
0.1.x与0.2.x两条线。 自 DSH0.1.6-alpha.2起,TypertCodec 契约从「读schema」改为「读create()工厂」——仍只写schema:的插件会在注册阶段直接抛错,把整棵插件树拖垮。自 0.5.2 起每个 codec 同时带schema与create: () => schema,因此两个时代的 DSH 都能加载。peer 范围自 0.6.4 起写>=0.1.2-rc.1—— 去掉上界,避免以后某个大版本被这道声明误挡(已逐字节核对dsh-typert-protocol与dsh-client-locale在0.1.7-rc.2 → 0.2.0-rc.1之间导出符号零增删) - 0.5.3 起带一层防御留痕。
deriveMessages()(仍是同步)、system-prompt/assemble事件、context.agent.session这条链在升级中都没变;但如果哪天 DSH 把它们改成异步或改了名,插件会在日志里报警,而不是像以前那样静默地不再注入记忆
卸载
在 profile 的 package.json 里删掉 sage-mem 依赖,并从 dsh.profile.bundles 移除 "sage-mem";pnpm install 后重启 DSH 即可。记忆 Markdown 文件留在原目录,不受影响。
相关项目
- DeepSeek Harness — DSH 本体,一切皆插件
- awesome-dsh-plugin — DSH 插件生态清单
旧版
本仓库早期是 SQLite + worker 架构,已归档到 sqlite-worker 分支。文件式是继任实现。
License
Apache-2.0